Создание прогноза в Excel для Windows
Если у вас есть статистические данные с зависимостью от времени, вы можете создать прогноз на их основе. При этом в Excel создается новый лист с таблицей, содержащей статистические и предсказанные значения, и диаграммой, на которой они отражены. С помощью прогноза вы можете предсказывать такие показатели, как будущий объем продаж, потребность в складских запасах или потребительские тенденции.
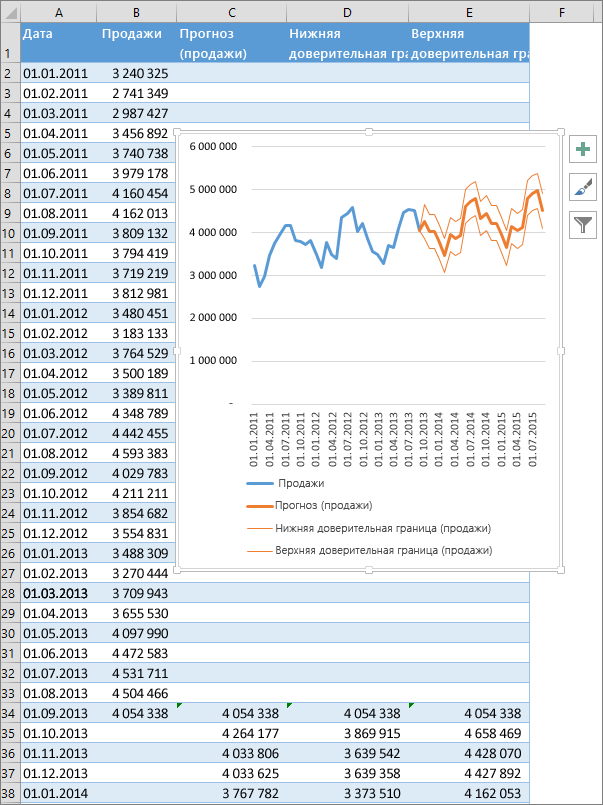
Создание прогноза
- На листе введите два ряда данных, которые соответствуют друг другу:
- ряд значений даты или времени для временной шкалы;
- ряд соответствующих значений показателя. Эти значения будут предсказаны для дат в будущем.
Примечание: Для временной шкалы требуются одинаковые интервалы между точками данных. Например, это могут быть месячные интервалы со значениями на первое число каждого месяца, годичные или числовые интервалы. Если на временной шкале не хватает до 30 % точек данных или есть несколько чисел с одной и той же меткой времени, это нормально. Прогноз все равно будет точным. Но для повышения точности прогноза желательно перед его созданием обобщить данные.
Совет: Если выделить ячейку в одном из рядов, Excel автоматически выделит остальные данные.
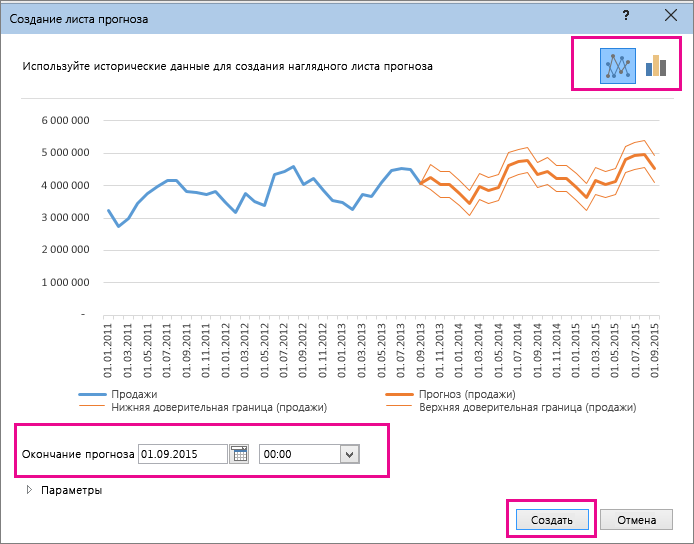
Настройка прогноза
Если вы хотите изменить дополнительные параметры прогноза, нажмите кнопку Параметры.
Сведения о каждом из вариантов можно найти в таблице ниже.
Параметры прогноза
Начало прогноза
Выберите дату, с которой должен начинаться прогноз. При выборе даты начала, которая наступает раньше, чем заканчиваются статистические данные, для построения прогноза используются только данные, предшествующие ей (это называется «ретроспективным прогнозированием»).
- Если вы начинаете прогноз перед последней точкой, вы сможете получить оценку точности прогноза, так как сможете сравнить прогнозируемый ряд с фактическими данными. Но если начать прогнозирование со слишком ранней даты, построенный прогноз может отличаться от созданного на основе всех статистических данных. При использовании всех статистических данных прогноз будет более точным.
- Если в ваших данных прослеживаются сезонные тенденции, то рекомендуется начинать прогнозирование с даты, предшествующей последней точке статистических данных.
Доверительный интервал
Установите или снимите флажок Доверительный интервал, чтобы показать или скрыть его. Доверительный интервал — это диапазон вокруг каждого предсказанного значения, в который в соответствии с прогнозом (при нормальном распределении) предположительно должны попасть 95 % точек, относящихся к будущему. Доверительный интервал помогает определить точность прогноза. Чем он меньше, тем выше достоверность прогноза для данной точки. Доверительный интервал по умолчанию определяется для 95 % точек, но это значение можно изменить с помощью стрелок вверх или вниз.
Сезонность — это число для длины (количества точек) сезонного шаблона и автоматически обнаруживается. Например, в ежегодном цикле продаж, каждый из которых представляет месяц, сезонность составляет 12. Автоматическое обнаружение можно переопрепредидить, выбрав установить вручную и выбрав число.
Примечание: Если вы хотите задать сезонность вручную, не используйте значения, которые меньше двух циклов статистических данных. При таких значениях этого параметра приложению Excel не удастся определить сезонные компоненты. Если же сезонные колебания недостаточно велики и алгоритму не удается их выявить, прогноз примет вид линейного тренда.
Диапазон временной шкалы
Здесь можно изменить диапазон, используемый для временной шкалы. Этот диапазон должен соответствовать параметру Диапазон значений.
Диапазон значений
Здесь можно изменить диапазон, используемый для рядов значений. Этот диапазон должен совпадать со значением параметра Диапазон временной шкалы.
Заполнить отсутствующие точки с помощью
Для обработки отсутствующих точек в Excel используется интерполяция, то есть отсутствующие точки будут заполнены в качестве взвешенного среднего значения соседних точек, если отсутствует менее 30 % точек. Чтобы нули в списке не были пропущены, выберите в списке пункт Нули.
Использование агрегатных дубликатов
Если данные содержат несколько значений с одной меткой времени, Excel находит их среднее. Чтобы использовать другой метод вычисления, например Медиана илиКоличество,выберите нужный способ вычисления из списка.
Включить статистические данные прогноза
Установите этот флажок, если хотите поместить на новом листе дополнительную статистическую информацию о прогнозе. При этом добавляется таблица статистики, созданная с помощью прогноза. Ets. Функция СТАТ и показатели, такие как коэффициенты сглаживания («Альфа», «Бета», «Гамма») и метрики ошибок (MASE, SMAPE, MAE, RMSE).
Формулы, используемые при прогнозировании
При использовании формулы для создания прогноза возвращаются таблица со статистическими и предсказанными данными и диаграмма. Прогноз предсказывает будущие значения на основе имеющихся данных, зависящих от времени, и алгоритма экспоненциального сглаживания (ETS) версии AAA.
Таблицы могут содержать следующие столбцы, три из которых являются вычисляемыми:
- столбец статистических значений времени (ваш ряд данных, содержащий значения времени);
- столбец статистических значений (ряд данных, содержащий соответствующие значения);
- столбец прогнозируемых значений (вычисленных с помощью функции ПРЕДСКАЗ.ЕTS);
- два столбца, представляющие доверительный интервал (вычисленные с помощью функции ПРЕДСКАЗ.ЕTS.ДОВИНТЕРВАЛ). Эти столбцы отображаются только при проверке доверительный интервал в разделе Параметры.
Скачивание образца книги
Дополнительные сведения
Вы всегда можете задать вопрос эксперту в Excel Tech Community или получить поддержку в сообществах.
Создание временной шкалы сводной таблицы для фильтрации дат
Вместо настройки фильтров для отображения дат вы можете воспользоваться временной шкалой сводной таблицы. Это параметр динамического фильтра, позволяющий легко фильтровать по дате или времени и переходить к нужному периоду с помощью ползунка. Чтобы добавить эту шкалу на лист, на вкладке Анализ нажмите кнопку Вставить временную шкалу.
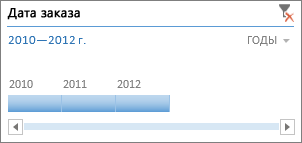
Как и срез для фильтрации данных, временную шкалу можно добавить один раз и затем использовать в любой момент для изменения диапазона времени сводной таблицы.
Ниже описано, как это сделать.
- Щелкните в любом месте сводной таблицы, чтобы показать группу Работа со сводными таблицами на ленте, и на вкладке Анализ нажмите кнопку Вставить временную шкалу.
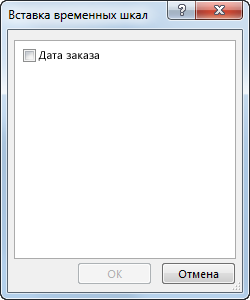
- В диалоговом окне Вставка временных шкал установите флажки рядом с нужными полями дат и нажмите кнопку ОК.
Использование временной шкалы для фильтрации по периоду времени
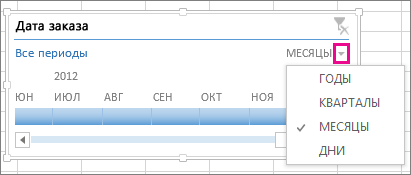
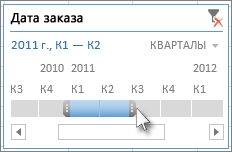
Вставив временную шкалу, вы можете фильтровать данные по периоду времени на одном из четырех уровней (годы, кварталы, месяцы или дни).
- Нажмите на стрелку рядом с отображаемым временным уровнем и выберите нужный вариант.
- Перетащите полосу прокрутки временной шкалы к периоду времени, который вы хотите проанализировать.
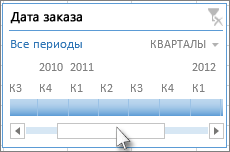
- В элементе управления отрезком времени нажмите на плитку периода времени и перетащите ее, чтобы добавить дополнительные плитки для выбора нужного диапазона дат. С помощью маркеров отрезка времени отрегулируйте диапазон дат с обеих сторон.
Использование временной шкалы с несколькими сводными таблицами
Если ваши сводные таблицы имеют один и тот же источник данных, вы можете использовать одну временную шкалу для фильтрации по нескольким сводным таблицам. Щелкните временную шкалу, а затем на вкладке Параметры нажмите кнопку Подключения к отчетам и выберите сводные таблицы, которые вы хотите добавить.
Очистка временной шкалы

Чтобы очистить временную шкалу, нажмите кнопку Очистить фильтр .
Совет: Если нужно объединить срезы с временной шкалой для фильтрации одного и того же поля дат, установите флажок Разрешить несколько фильтров для поля в диалоговом окне Параметры сводной таблицы (Работа со сводными таблицами > Анализ > Параметры > вкладка Итоги и фильтры).
Настройка временной шкалы
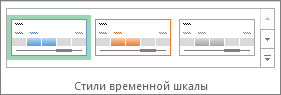
Если временная шкала включает в себя данные сводной таблицы, вы можете переместить ее в более удобное расположение и изменить ее размер. Кроме того, вы можете изменить стиль временной шкалы — это удобно, если у вас несколько шкал.
- Чтобы переместить временную шкалу, просто перетащите ее в нужное расположение.
- Чтобы изменить размер временной шкалы, нажмите на нее, а затем выберите нужный размер, перетаскивая маркеры размера.
- Для изменения стиля временной шкалы, нажмите на нее, чтобы вывести на экран меню Инструменты временной шкалы, и выберите нужный стиль на вкладкеПараметры.
Дополнительные сведения
Вы всегда можете задать вопрос эксперту в Excel Tech Community или получить поддержку в сообществах.
Анализ временных рядов и прогнозирование в Excel на примере
Анализ временных рядов позволяет изучить показатели во времени. Временной ряд – это числовые значения статистического показателя, расположенные в хронологическом порядке.
Подобные данные распространены в самых разных сферах человеческой деятельности: ежедневные цены акций, курсов валют, ежеквартальные, годовые объемы продаж, производства и т.д. Типичный временной ряд в метеорологии, например, ежемесячный объем осадков.
Временные ряды в Excel
Если фиксировать значения какого-то процесса через определенные промежутки времени, то получатся элементы временного ряда. Их изменчивость пытаются разделить на закономерную и случайную составляющие. Закономерные изменения членов ряда, как правило, предсказуемы.
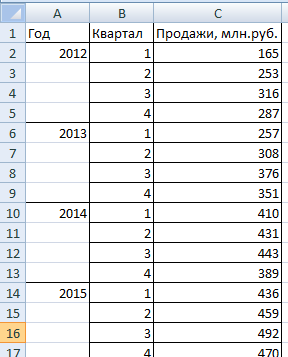
Сделаем анализ временных рядов в Excel. Пример: торговая сеть анализирует данные о продажах товаров магазинами, находящимися в городах с населением менее 50 000 человек. Период – 2012-2015 гг. Задача – выявить основную тенденцию развития.
Внесем данные о реализации в таблицу Excel:
На вкладке «Данные» нажимаем кнопку «Анализ данных». Если она не видна, заходим в меню. «Параметры Excel» — «Надстройки». Внизу нажимаем «Перейти» к «Надстройкам Excel» и выбираем «Пакет анализа».
Подключение настройки «Анализ данных» детально описано здесь.
Нужная кнопка появится на ленте.
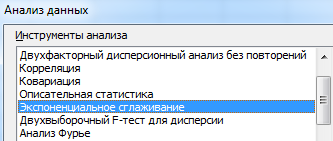
Из предлагаемого списка инструментов для статистического анализа выбираем «Экспоненциальное сглаживание». Этот метод выравнивания подходит для нашего динамического ряда, значения которого сильно колеблются.
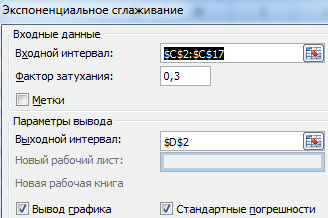
Заполняем диалоговое окно. Входной интервал – диапазон со значениями продаж. Фактор затухания – коэффициент экспоненциального сглаживания (по умолчанию – 0,3). Выходной интервал – ссылка на верхнюю левую ячейку выходного диапазона. Сюда программа поместит сглаженные уровни и размер определит самостоятельно. Ставим галочки «Вывод графика», «Стандартные погрешности».
Закрываем диалоговое окно нажатием ОК. Результаты анализа:
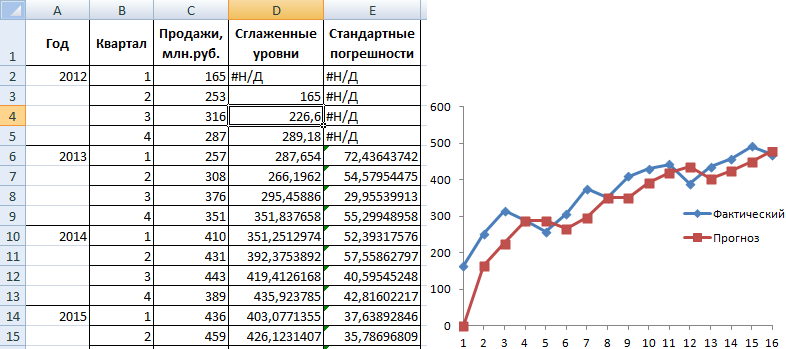
Для расчета стандартных погрешностей Excel использует формулу: =КОРЕНЬ(СУММКВРАЗН(‘диапазон фактических значений’; ‘диапазон прогнозных значений’)/ ‘размер окна сглаживания’). Например, =КОРЕНЬ(СУММКВРАЗН(C3:C5;D3:D5)/3).
Прогнозирование временного ряда в Excel
Составим прогноз продаж, используя данные из предыдущего примера.
На график, отображающий фактические объемы реализации продукции, добавим линию тренда (правая кнопка по графику – «Добавить линию тренда»).
Настраиваем параметры линии тренда:
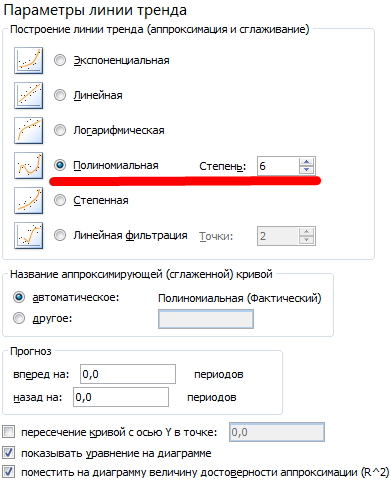
Выбираем полиномиальный тренд, что максимально сократить ошибку прогнозной модели.
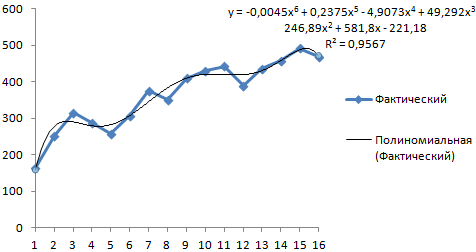
R2 = 0,9567, что означает: данное отношение объясняет 95,67% изменений объемов продаж с течением времени.
Уравнение тренда – это модель формулы для расчета прогнозных значений.
Большинство авторов для прогнозирования продаж советуют использовать линейную линию тренда. Чтобы на графике увидеть прогноз, в параметрах необходимо установить количество периодов.
Получаем достаточно оптимистичный результат:
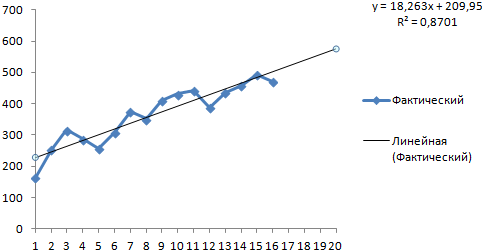
В нашем примере все-таки экспоненциальная зависимость. Поэтому при построении линейного тренда больше ошибок и неточностей.
Для прогнозирования экспоненциальной зависимости в Excel можно использовать также функцию РОСТ.
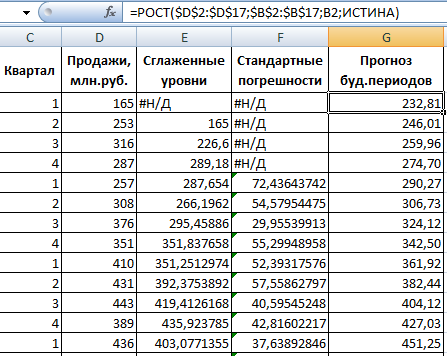
Для линейной зависимости – ТЕНДЕНЦИЯ.
При составлении прогнозов нельзя использовать какой-то один метод: велика вероятность больших отклонений и неточностей.
- Excel Formula Examples
- Создать таблицу
- Форматирование
- Функции Excel
- Формулы и диапазоны
- Фильтр и сортировка
- Диаграммы и графики
- Сводные таблицы
- Печать документов
- Базы данных и XML
- Возможности Excel
- Настройки параметры
- Уроки Excel
- Макросы VBA
- Скачать примеры
Прогнозирование временных рядов в MS EXCEL (обзорная статья)
В первом разделе статьи модели для прогнозирования временных рядов сравниваются с моделями, построение которых основано на причинно-следственных закономерностях.
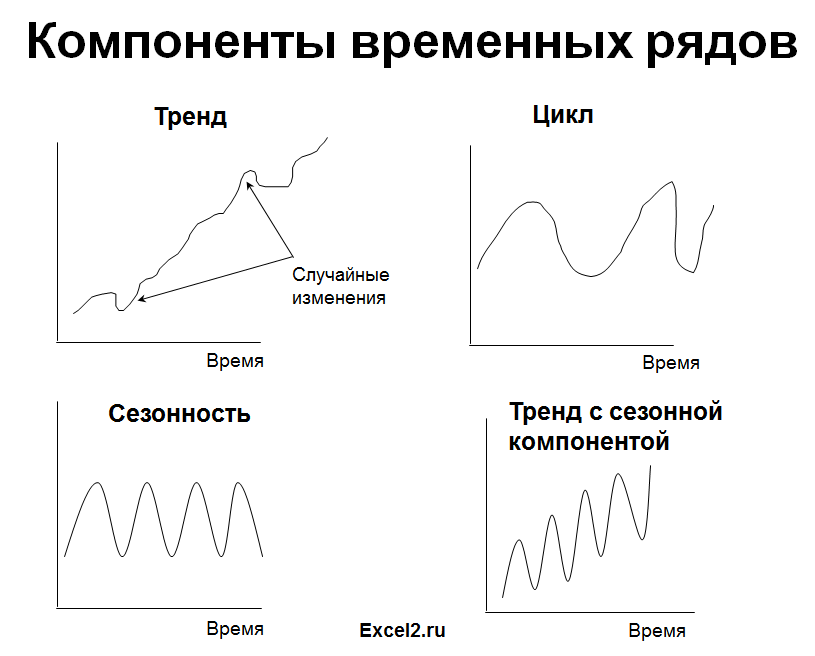
Во втором разделе приведен краткий обзор трендов временных рядов (линейный и сезонный тренд, стационарный процесс). Для каждого тренда предложена модель для прогнозирования.
Затем даны ссылки на сайты по теории прогнозирования временных рядов и содержащие базы статистических данных.
Disclaimer:
Напоминаем, что задача сайта excel2.ru (раздел Временные ряды ) продемонстрировать использование MS EXCEL для решения задач, связанных с прогнозированием временных рядов. Поэтому, статистические термины и определения приводятся лишь для логики изложения и демонстрации идей. Сайт не претендует на математическую строгость изложения статистики. Однако в наших статьях:
• ПОЛНОСТЬЮ описан встроенный в EXCEL инструментарий по анализу временных рядов (в составе надстройки Пакет анализа , различных типов Диаграмм ( гистограмма , линия тренда ) и формул);
• созданы файлы примера для построения соответствующих графиков, прогнозов и их интервалов предсказания, вычисления ошибок, генерации рядов (с трендами и сезонностью ) и пр.
Модели временных рядов и модели предметной области
Напомним, что временным рядом (англ. Time Series) называют совокупность наблюдений изучаемой величины, упорядоченную по времени. Наблюдения производятся через одинаковые периоды времени. Другой информацией, кроме наблюдений, исследователь не обладает.
Основной целью исследования временного ряда является его прогнозирование – предсказание будущих значений изучаемой величины. Прогнозирование основывается только на анализе значений ряда в предыдущие периоды, точнее — на идентификации трендов ряда. Затем, после определения трендов, производится моделирование этих трендов и, наконец, с помощью этих моделей — экстраполяция на будущие периоды.
Таким образом, прогнозирование основывается на фактических данных (значениях временного ряда) и модели ( скользящее среднее , экспоненциальное сглаживание , двойное и тройное экспоненциальное сглаживание и др.).
Примечание : Прогнозирование методом Скользящее среднее в MS EXCEL подробно рассмотрено в одноименной статье .
В отличие от методов временных рядов, где зависимости ищутся внутри самого процесса , в «моделях предметной области» (англ. «Causal Models») кроме самих данных используют еще и законы предметной области.
Примером построения «моделей предметной области» ( моделей строящихся на основе причинно-следственных закономерностей, априорно известных независимо от имеющихся данных ) может быть промышленный процесс изготовления защитной ткани. Пусть в таком процессе известно, что прочность материала ткани зависит от температуры в реакторе, в котором производится процесс полимеризации (температура — контролируемый фактор). Однако, прочность материала является все же случайной величиной, т.к. зависит помимо температуры также и от множества других факторов (качества исходного сырья, температуры окружающей среды, номера смены, умений аппаратчика реактора и пр.). Эти другие факторы в процессе производства стараются держать постоянными (сырье проходит входной контроль и его поставщик не меняется; в помещении, где стоит реактор, поддерживается постоянная температура в течение всего года; аппаратчики проходят обучение и регулярно проводится переаттестация). Задачей статистических методов в этом случае – предсказать значение случайной величины (прочности) при заданном значении изменяемого фактора (температуры).
Обычно для описания таких процессов (зависимость случайной величины от управляемого фактора) являются предметом изучения в разделе статистики « Регрессионный анализ », т.к. есть основания сделать гипотезу о существовании причинно-следственной связи между управляемым фактором и прогнозируемой величиной.
Модели, строящиеся на основе причинно-следственных закономерностей, упомянуты в этой статье для того чтобы акцентировать, что их изучение предшествует теме «временные ряды». Так, часть методов, например «Регрессионный анализ» (используется метод наименьших квадратов — МНК ), используется при анализе временных рядов, но изучаются в моделях предметной области, поэтому неподготовленным «пытливым умам» не стоит игнорировать раздел статистики « Статистический вывод », в котором проверяются гипотезы о равенстве среднего значения и строятся доверительные интервалы для оценки среднего , и упомянутый выше «Регрессионный анализ».
Кратко о типах процессов и моделях для их прогнозирования
Выбор подходящей модели прогнозирования делается с учетом типа моделируемого процесса (наличие трендов). Рассмотрим основные типы процессов.
1. Стационарный процесс
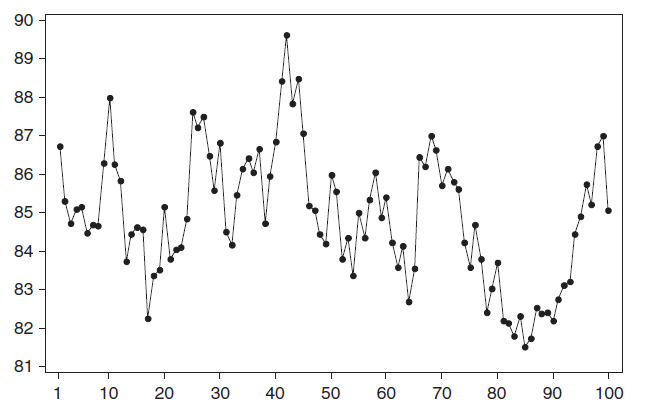
Стационарный процесс – это случайный процесс чьи характеристики не зависят от времени их наблюдения. Этими характеристиками являются среднее значение , дисперсия и автоковариация. В стационарном процессе не могут быть выделены предсказуемые паттерны. Соответственно ряды демонстрирующие тренд и сезонность — не стационарны. А вот ряд с цикличностью (апериодической) является стационарным, т.к. на долгосрочном временном интервале появление циклов предсказать невозможно.
Почему стационарный процесс важен? Так как стационарность подразумевает нахождение процесса в состоянии статистической стабильности, то такие временные ряды имеют постоянное среднее значение и дисперсию, которые определяются стандартным образом.
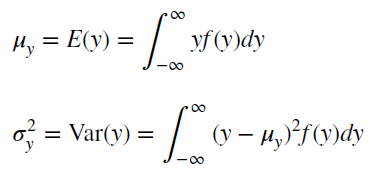
Также для стационарного процесса определяется функция автокорреляции – совокупность коэффициентов корреляции значений временного ряда с собственными значениями, сдвинутыми по времени на один или несколько периодов. Сдвиг на несколько временных периодов часто называется лагом (обозначается k).
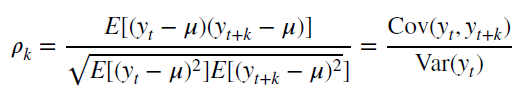
Функция автокорреляции является важным источником информации о временном ряде.
Примером стационарного процесса является колебания биржевого индекса, состоящего из стоимости акций нескольких компаний, около определённого значения (в период стабильности рынка).
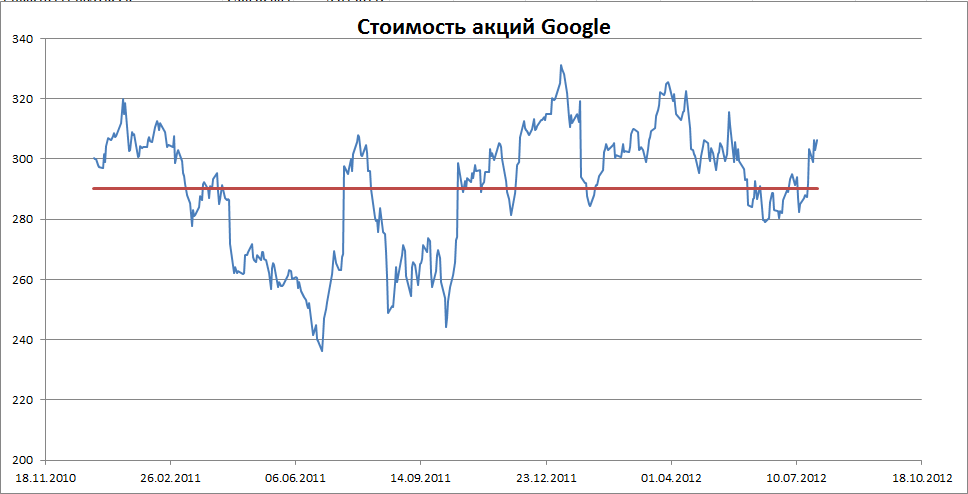
Примечание : график стоимости акций построен на реальных данных, см. файл примера Google .
Специальным видом стационарного процесса является белый шум. У этого процесса: среднее значений ряда равно 0, имеется конечная дисперсия и отсутствует корреляция между значениями исходного ряда и рядом сдвинутым на произвольное количество периодов (лагов). В MS EXCEL белый шум можно сгенерировать функцией СЛЧИС().
2. Линейный тренд
Некоторые процессы генерируют тренд (монотонное изменение значений ряда). Например, линейный тренд y=a*x+b, точнее y=a*t+b, где t – это время. Примером такого (не стационарного) процесса может быть монотонный рост стоимости недвижимости в некотором районе.
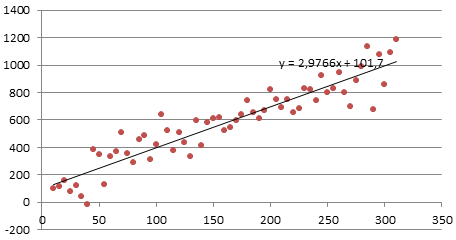
Для вычисления прогнозного значения можно воспользоваться методами Регрессионного анализа и подобрать параметры тренда: наклон и смещение по вертикали.
Примечание : Про генерацию случайных значений, демонстрирующих линейный тренд, можно посмотреть в статье Генерация данных для простой линейной регрессии в EXCEL .
3. Процессы, демонстрирующие сезонность
В сезонном процессе присутствует точно или примерно фиксированный интервал изменений, например, продажи некоторых товаров имеют четко выраженный пик в ноябре-декабре каждого года в связи с праздником.
Для прогнозирования вычисляется индекс сезонности, затем ряд очищается от сезонной компоненты. Если ряд также демонстрирует тренд, то после очистки от сезонности используются методы регрессионного анализа для вычисления тренда.
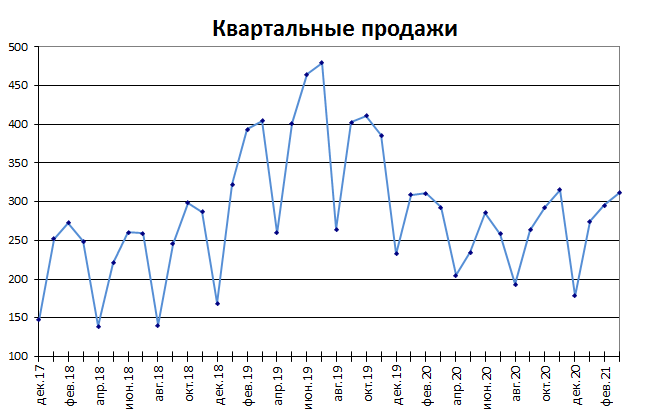
Примечание : Про генерацию случайных значений, демонстрирующих сезонность, можно посмотреть в статье Генерация сезонных трендов в EXCEL.
Часто на практике встречаются ряды, являющиеся комбинацией вышеуказанных типов тенденций.
О моделях прогнозирования
В качестве простейшей модели для прогноза можно взять последнее значение индекса. Этой модели соответствует следующий ход мысли исследователя: «Если значение индекса вчера было 306, то и завтра будет 306».
Этой модели соответствует формула Y прогноз(t) = Y t-1 (прогноз в момент времени t равен значению временного ряда в момент t-1).
Другой моделью является среднее за последние несколько периодов ( скользящее среднее ). Этой модели соответствует другой ход мысли исследователя: «Если среднее значение индекса за последние n периодов было 540, то и завтра будет 540». Этой модели соответствует формула Y прогноз(t) =(Y t-1 + Y t-2 +…+Y t-n )/n
Обратите внимание, что значения временного ряда берутся с одинаковым весом 1/n, то есть более ранние значения (в момент t-n) влияют на прогноз также как и недавние (в момент t-1). Конечно, в случае, если речь идет о стационарном процессе (без тренда), такая модель может быть приемлема. Чем больше количество периодов усреднения (n), тем меньше влияние каждого индивидуального наблюдения.
Третьей моделью для стационарного процесса может быть экспоненциальное сглаживание . В этом случае веса более ранних периодов будут меньше чем веса поздних. При этом учитываются все предыдущие наблюдения. Вес каждого последующего наблюдения больше на 1-α (Фактор затухания), где α (альфа) – это константа сглаживания (от 0 до 1).
Этой модели соответствует формула Y прогноз(t) =α*Y t-1 + α*(1-α)*Y t-2 + α*(1-α)2*Y t-3 +…)
Формулу можно переписать через предыдущий прогноз Y прогноз(t) =α*Y t-1 +(1- α)* Y прогноз(t-1) = α*(Y t-1 — Y прогноз(t-1) )+Y прогноз(t-1) = α*(ошибка прошлого прогноза)+ прошлый прогноз
При экспоненциальном сглаживании прогнозное значение равно сумме последнего наблюдения с весом альфа и предыдущего прогноза с весом (1-альфа). Этой модели соответствует следующий ход мысли исследователя: «Вчера рано утром я предсказывал, что индекс будет равен 500, но вчера в конце дня значение индекса составило 480 (ошибка составила 20). Поэтому за основу сегодняшнего прогноза я беру вчерашний прогноз и корректирую его на величину ошибки, умноженную на альфа. Параметр альфа (константа) я найду методом экспоненциального сглаживания».
Подробнее о методе прогнозирования на основе экспоненциального сглаживания можно найти в этой статье .
Полезный сигнал и шум
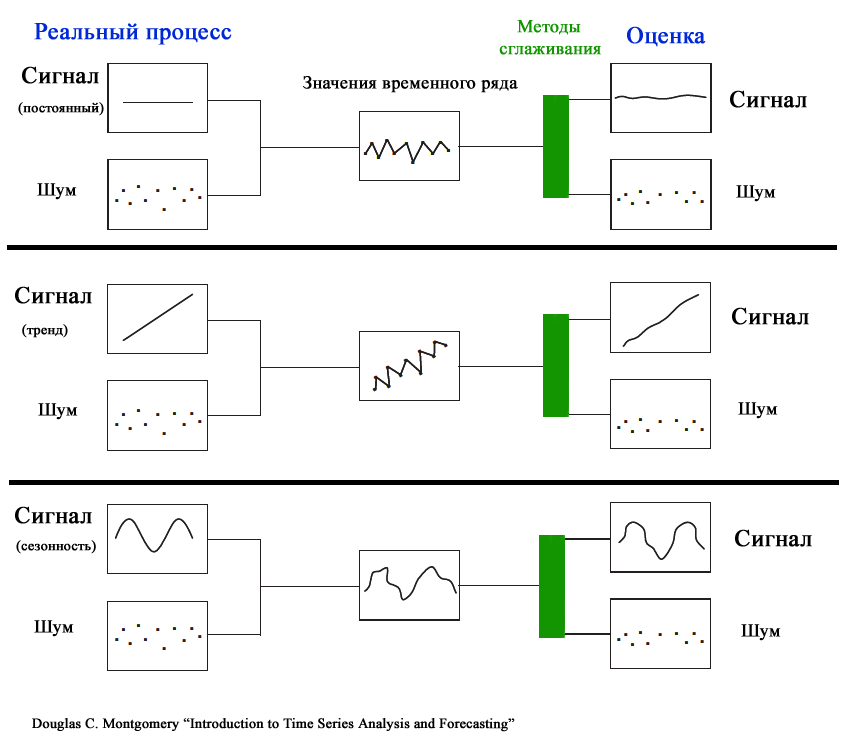
Из-за случайного разброса, присущему временному ряду, временной ряд представляют как комбинацию двух различных компонентов: полезного сигнала и шума (ошибки). Полезный сигнал следует одному из 3-х вышеуказанных типов процессов. Сигнал может быть смоделирован и соответственно спрогнозирован. Шум представляет собой случайные ошибки (со средним значением =0, отсутствием корреляции и с фиксированной дисперсией ).
Основной задачей моделирования идентификация полезного сигнала, имеющего определенный тренд, от непредсказуемого шума. Для этого как раз и используются Модели сглаживания.
Ссылки на источники статистических данных и обучающие материалы
Все источники англоязычные.