Как рассчитать коэффициент корреляции Пирсона вручную
Коэффициент корреляции Пирсона измеряет линейную связь между двумя переменными.
Он всегда принимает значение от -1 до 1, где:
- -1 указывает на совершенно отрицательную линейную корреляцию между двумя переменными
- 0 указывает на отсутствие линейной корреляции между двумя переменными
- 1 указывает на совершенно положительную линейную корреляцию между двумя переменными.
Формула для расчета коэффициента корреляции Пирсона, обозначаемая r , выглядит следующим образом:

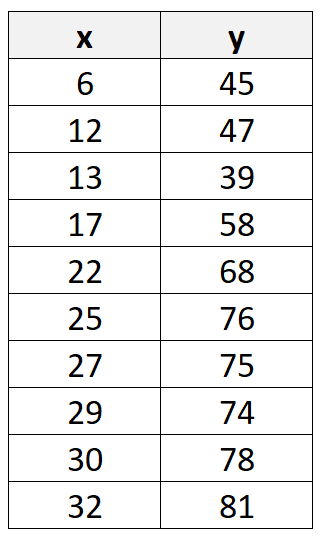
Источник: Википедия В этом руководстве представлен пошаговый пример того, как вручную рассчитать коэффициент корреляции Пирсона для следующего набора данных:
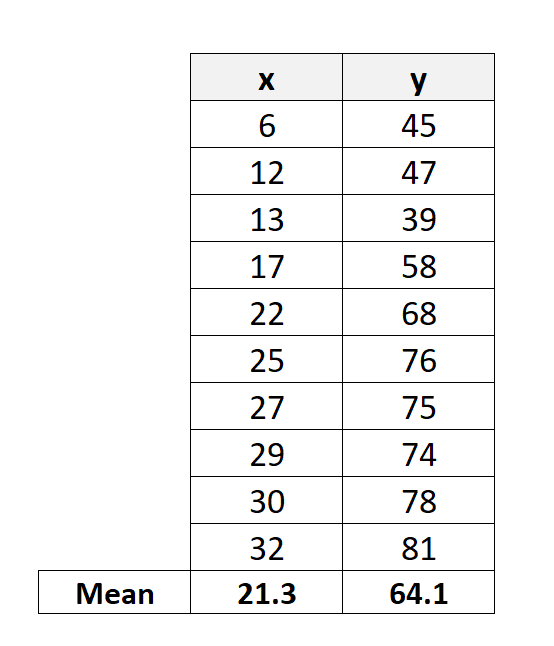
Шаг 1: вычислить среднее значение X и Y
Сначала мы вычислим среднее значение значений X и Y:
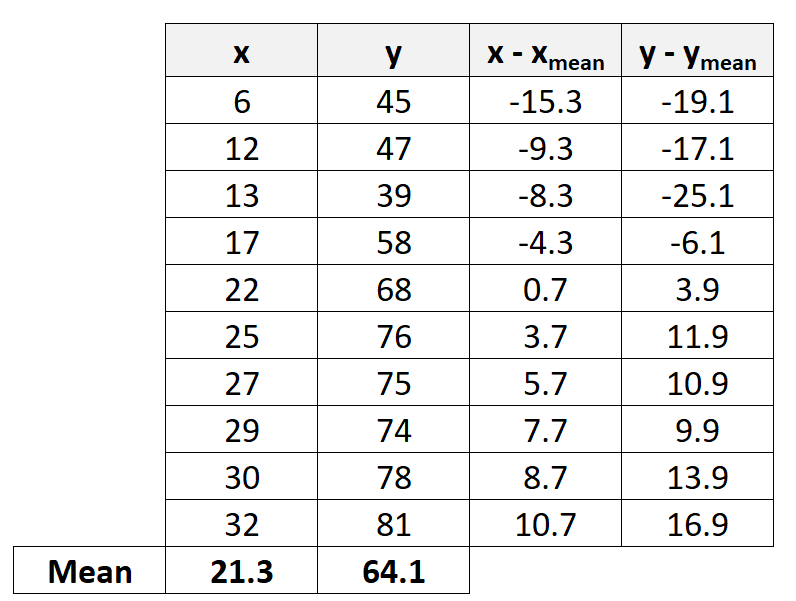
Шаг 2: Рассчитайте разницу между средними значениями
Далее мы рассчитаем разницу между каждым из отдельных значений X и Y и их соответствующими средними значениями:
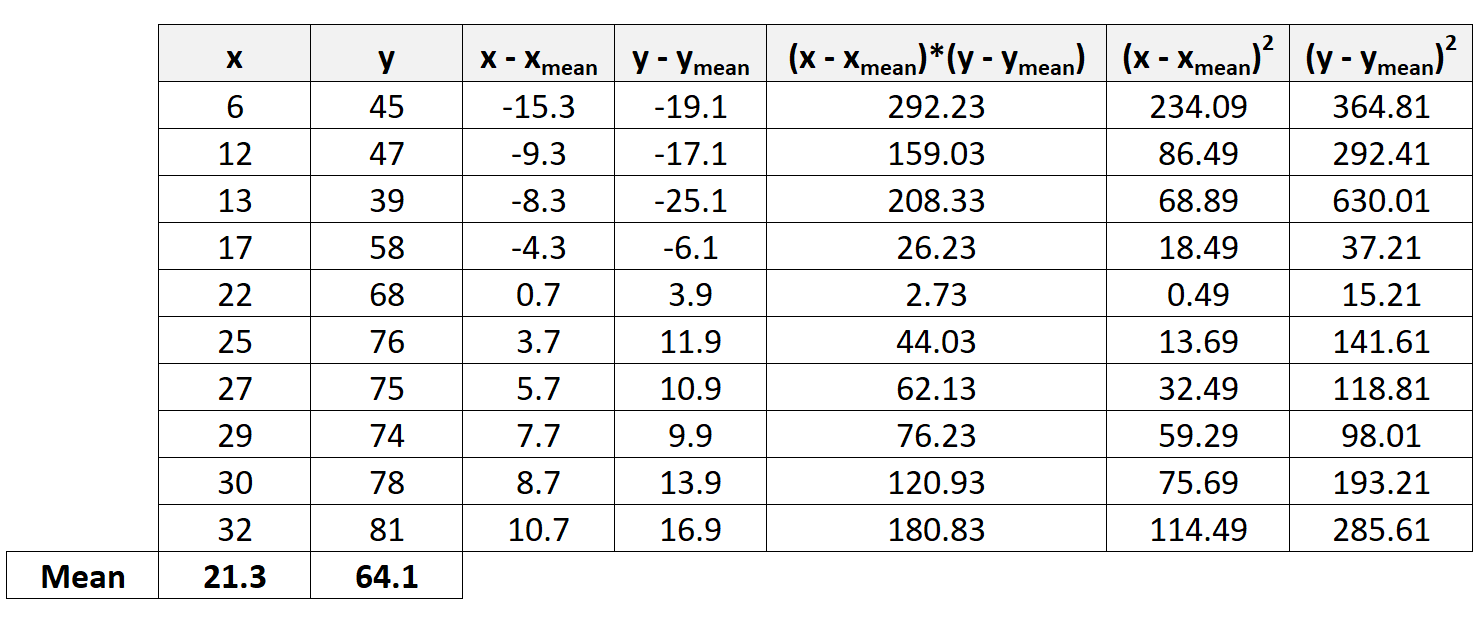
Шаг 3: Рассчитайте оставшиеся значения
Далее мы рассчитаем оставшиеся значения, необходимые для завершения формулы коэффициента корреляции Пирсона:
Шаг 4: Рассчитайте суммы
Далее мы вычислим суммы последних трех столбцов:
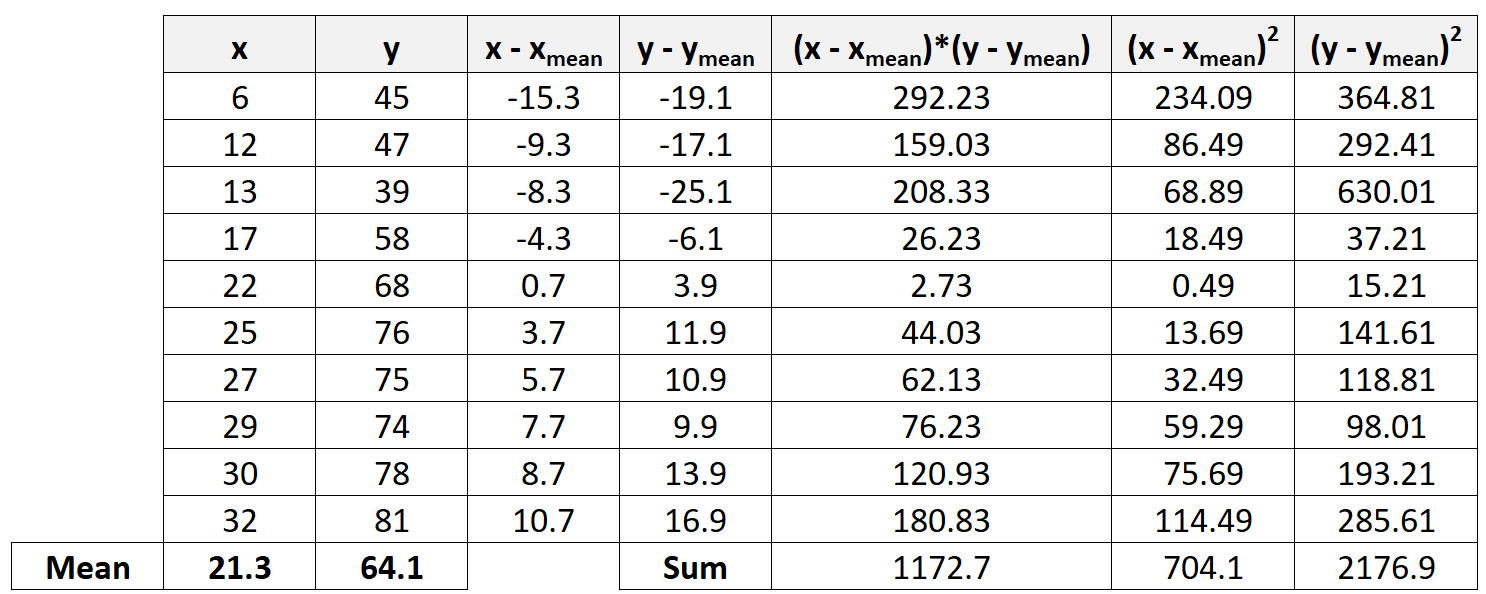
Шаг 5. Рассчитайте коэффициент корреляции Пирсона.
Теперь мы просто подставим суммы из предыдущего шага в формулу коэффициента корреляции Пирсона:
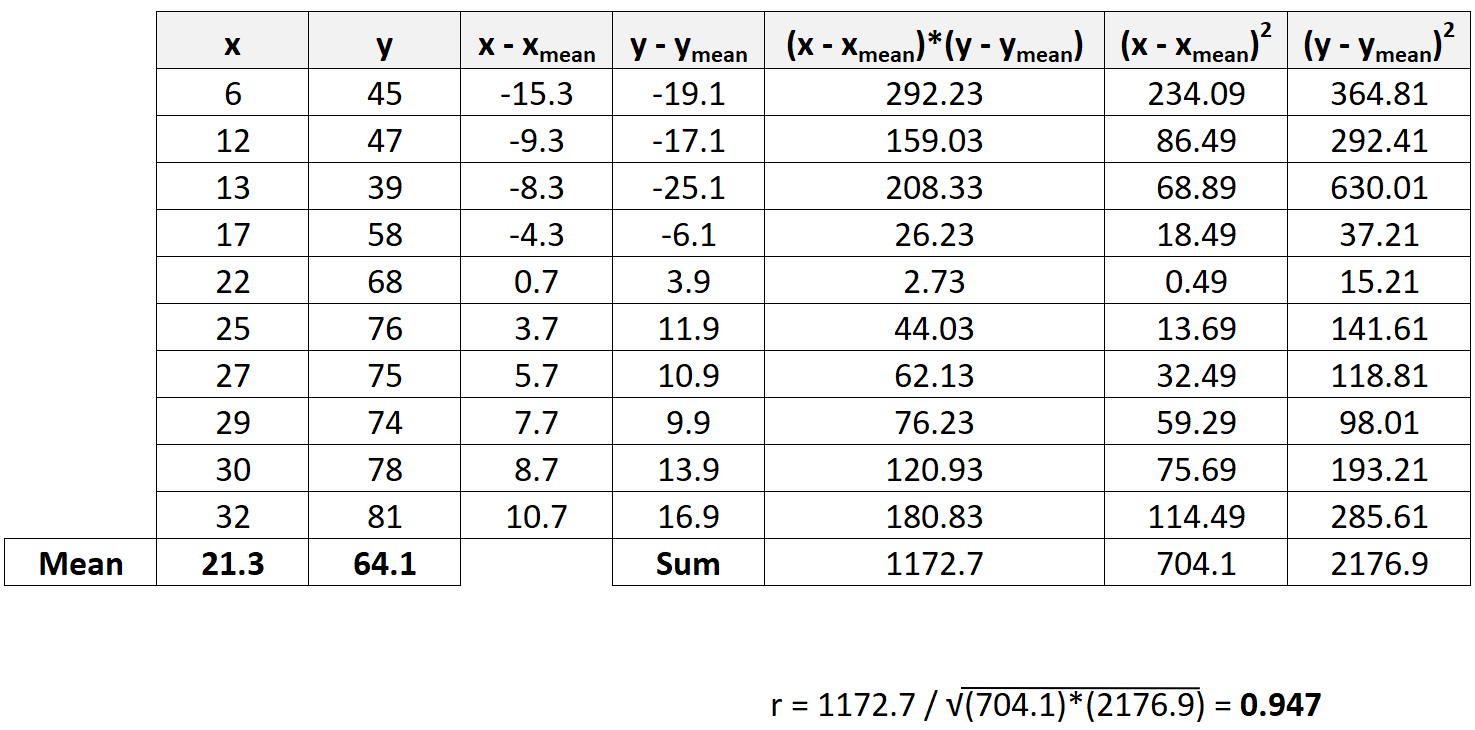
Коэффициент корреляции Пирсона оказывается равным 0,947 .
Поскольку это значение близко к 1, это свидетельствует о сильной положительной корреляции X и Y.
Другими словами, по мере увеличения значения X значение Y также увеличивается весьма предсказуемым образом.
Коэффициент корреляции Пирсона
Коэффициент корреляции Пирсона (также известный как «коэффициент корреляции продукта и момента») является мерой линейной связи между двумя переменными X и Y. Он имеет значение от -1 до 1, где:
- -1 указывает на совершенно отрицательную линейную корреляцию между двумя переменными
- 0 указывает на отсутствие линейной корреляции между двумя переменными
- 1 указывает на совершенно положительную линейную корреляцию между двумя переменными.
Формула для нахождения коэффициента корреляции Пирсона
Формула для нахождения коэффициента корреляции Пирсона, обозначаемого как r , для выборки данных ( из Википедии ):
Скорее всего, вам никогда не придется вычислять эту формулу вручную, так как вы можете использовать программное обеспечение, чтобы сделать это за вас, но полезно иметь представление о том, что именно делает эта формула, на примере.
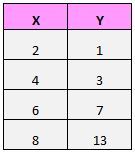
Предположим, у нас есть следующий набор данных:
Если мы нанесем эти пары (X, Y) на диаграмму рассеяния, это будет выглядеть так:
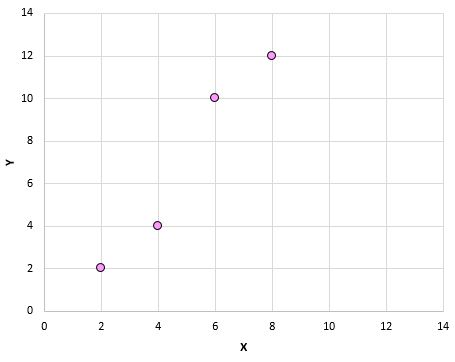
Просто взглянув на эту диаграмму рассеяния, мы можем сказать, что существует положительная связь между переменными X и Y: когда X увеличивается, Y также имеет тенденцию к увеличению. Но чтобы точно определить, насколько положительно связаны эти две переменные, нам нужно найти коэффициент корреляции Пирсона.
Давайте сосредоточимся только на числителе формулы:
Вот визуальный взгляд на то, что мы только что сделали:
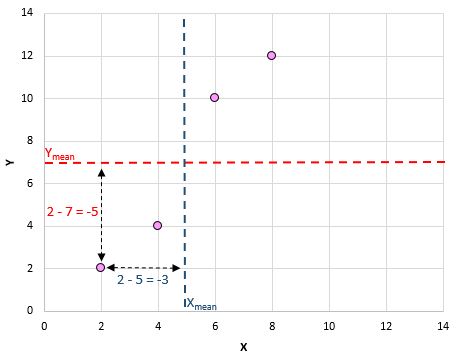
Далее нам просто нужно сделать это для каждой отдельной пары:
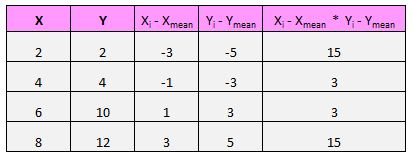
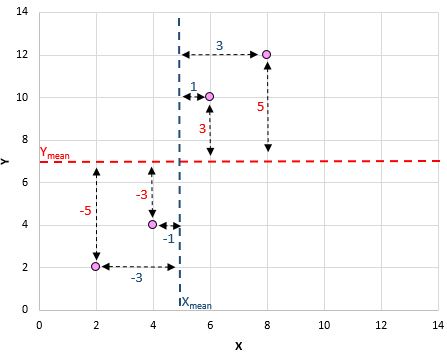
Последний шаг для получения числителя формулы — просто сложить все эти значения:
15 + 3 + 3 + 15 = 36
Затем знаменатель формулы говорит нам найти сумму всех квадратов разностей для x и y, затем умножить эти два числа вместе, а затем извлечь квадратный корень:
Затем мы перемножим эти два числа вместе: 20 * 68 = 1360.
Наконец, мы возьмем квадратный корень: √ 1360 = 36,88 .
Итак, мы нашли, что числитель формулы равен 36, а знаменатель равен 36,88. Это означает, что наш коэффициент корреляции Пирсона равен r = 36/36,88 = 0,976.
Это число близко к 1, что указывает на сильную положительную линейную связь между нашими переменными X и Y. Это подтверждает взаимосвязь, которую мы видели на диаграмме рассеяния.
Визуализация корреляций
Напомним, что коэффициент корреляции Пирсона говорит нам о типе линейной связи (положительная, отрицательная, отсутствие) между двумя переменными, а также о силе этой связи (слабая, умеренная, сильная).
Когда мы строим диаграмму рассеяния двух переменных, мы можем видеть реальную связь между двумя переменными. Вот множество различных типов линейных отношений, которые мы можем увидеть:
Сильная, положительная связь: по мере увеличения переменной по оси X переменная по оси Y также увеличивается. Точки расположены плотно друг к другу, что указывает на прочную связь.
Коэффициент корреляции Пирсона: 0,94
Слабая, положительная связь: по мере увеличения переменной по оси X переменная по оси Y также увеличивается. Точки довольно разбросаны, что указывает на слабую связь.
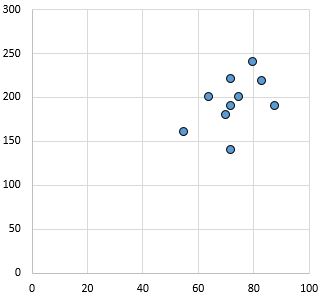
Коэффициент корреляции Пирсона: 0,44
Нет взаимосвязи: нет четкой взаимосвязи (положительной или отрицательной) между переменными.
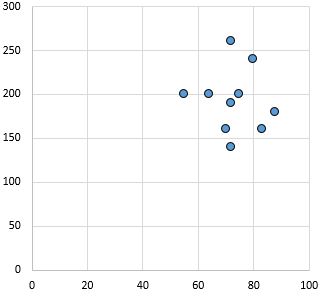
Коэффициент корреляции Пирсона: 0,03
Сильная, отрицательная связь: по мере увеличения переменной по оси X переменная по оси Y уменьшается. Точки расположены плотно друг к другу, что указывает на сильную связь.
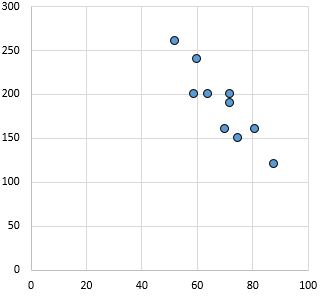
Коэффициент корреляции Пирсона: -0,87
Слабая, отрицательная связь: по мере увеличения переменной по оси X переменная по оси Y уменьшается. Точки довольно разбросаны, что указывает на слабую связь.
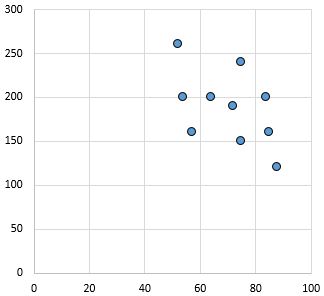
Коэффициент корреляции Пирсона: – 0,46
Проверка значимости коэффициента корреляции Пирсона
Когда мы находим коэффициент корреляции Пирсона для набора данных, мы часто работаем с выборкой данных, полученной из большей совокупности.Это означает, что можно найти ненулевую корреляцию для двух переменных, даже если они фактически не коррелированы в генеральной совокупности.
Например, предположим, что мы делаем диаграмму рассеяния для переменных X и Y для каждой точки данных во всей совокупности, и она выглядит следующим образом:
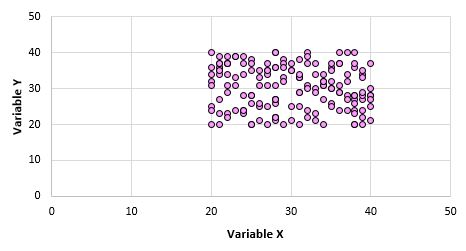
Ясно, что эти две переменные не коррелированы. Однако возможно, что когда мы берем выборку из 10 точек из генеральной совокупности, мы выбираем следующие точки:
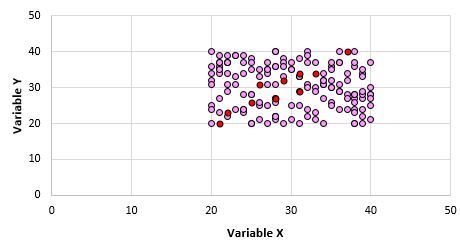
Мы можем обнаружить, что коэффициент корреляции Пирсона для этой выборки точек равен 0,93, что указывает на сильную положительную корреляцию, несмотря на то, что корреляция населения равна нулю.
Чтобы проверить, является ли корреляция между двумя переменными статистически значимой, мы можем найти следующую тестовую статистику:
Тестовая статистика T = r * √ (n-2) / (1-r 2 )
где n — количество пар в нашей выборке, r — коэффициент корреляции Пирсона, а тестовая статистика T следует за распределением с n-2 степенями свободы.
Давайте рассмотрим пример того, как проверить значимость коэффициента корреляции Пирсона.
Пример
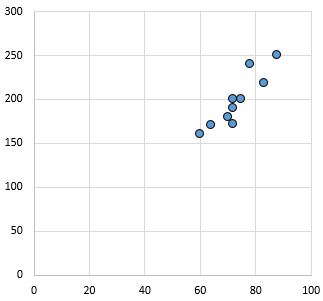
Следующий набор данных показывает рост и вес 12 человек:
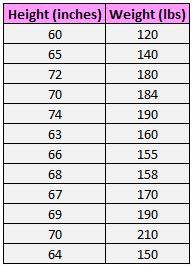
Диаграмма рассеяния ниже показывает значение этих двух переменных:
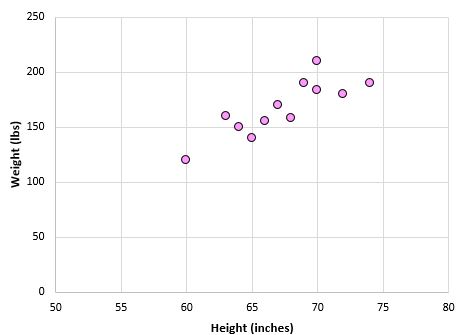
Коэффициент корреляции Пирсона для этих двух переменных составляет r = 0,836.
Статистика теста T = 0,836 * √ (12 -2) / (1-0,836 2 ) = 4,804.
Предостережения
Хотя коэффициент корреляции Пирсона может быть полезен для определения того, имеют ли две переменные линейную связь, мы должны помнить о трех вещах при интерпретации коэффициента корреляции Пирсона:
1. Корреляция не подразумевает причинно-следственной связи. Тот факт, что две переменные коррелированы, не означает, что одна из них обязательно вызывает более или менее частое появление другой. Классическим примером этого является положительная корреляция между продажами мороженого и нападениями акул. Когда продажи мороженого увеличиваются в определенное время года, количество нападений акул также увеличивается.
Означает ли это, что потребление мороженого вызывает нападения акул? Конечно нет! Это просто означает, что летом как потребление мороженого, так и нападения акул, как правило, увеличиваются, поскольку летом мороженое более популярно, а летом больше людей ходят в океан.
2. Корреляции чувствительны к выбросам. Один экстремальный выброс может резко изменить коэффициент корреляции Пирсона. Рассмотрим пример ниже:
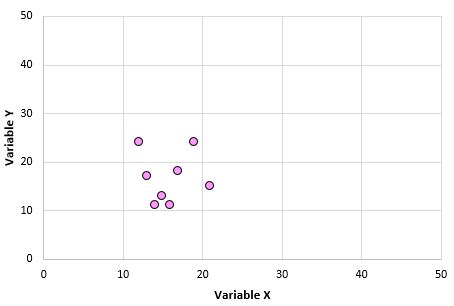
Переменные X и Y имеют коэффициент корреляции Пирсона 0,00.Но представьте, что у нас есть один выброс в наборе данных:
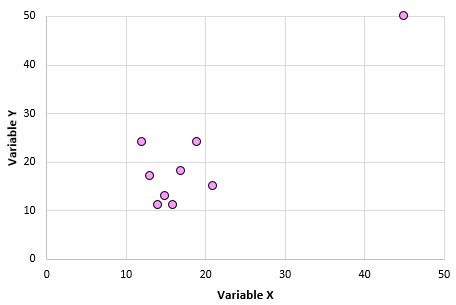
Теперь коэффициент корреляции Пирсона для этих двух переменных равен 0,878.Один этот выброс меняет все. Вот почему, когда вы вычисляете корреляцию для двух переменных, рекомендуется визуализировать переменные с помощью диаграммы рассеяния для проверки выбросов.
3. Коэффициент корреляции Пирсона не фиксирует нелинейные отношения между двумя переменными. Представьте, что у нас есть две переменные со следующими отношениями:
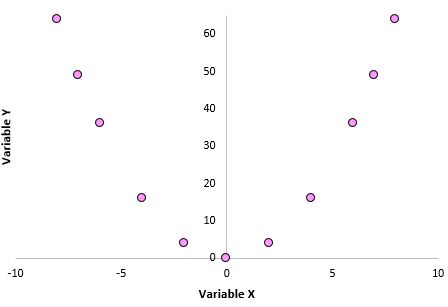
Коэффициент корреляции Пирсона для этих двух переменных равен 0,00, поскольку между ними нет линейной зависимости. Однако эти две переменные имеют нелинейную связь: значения y — это просто квадрат значений x.
При использовании коэффициента корреляции Пирсона помните, что вы просто проверяете, связаны ли две переменные линейно.Даже если коэффициент корреляции Пирсона говорит нам, что две переменные не коррелированы, они все равно могут иметь некоторую нелинейную связь. Это еще одна причина, по которой полезно создавать диаграмму рассеяния при анализе взаимосвязи между двумя переменными — это может помочь вам обнаружить нелинейную взаимосвязь.
19. Линейный коэффициент корреляции
Эта тема планировалась более 10 лет назад и вот, наконец, я здесь…. И вы здесь! И это замечательно! Даже не то слово. Это корреляционно.
О корреляции речь зашла в статьях об аналитической и комбинационной группировке, в результате чего перед нами нарисовались некоторые эмпирические показателями корреляции (прочитайте хотя бы «по диагонали»!). И сейчас на очереди линейный коэффициент корреляции, популярный настолько, что по умолчанию под коэффициентом корреляции понимают именно его. …Да, всё верно – существует довольно много разных коэффициентов корреляции. Однако всему своё время.
Материал данной темы состоит из двух уровней:
– начального, для всех – вплоть до студентов психологических и социологических факультетов, блондинок, брюнеток, школьников, бабушек, дедушек, etc и
– продвинутого, где я разберу более редкие задачи, а некоторые даже не буду разбирать 🙂
В результате вы научитесь БЫСТРО решать типовые задачи (видео прилагается) и для самых ленивых есть калькуляторы. И пока не запамятовал, хочу порекомендовать корреляционно-регрессионный анализ для ваших научных работ и практических исследований – наряду со статистическими гипотезами, это самая настоящая находка в плане новизны и творческих изысканий.
Оглавление:
и по просьбам учащихся:
то было для «чайников», для начала достаточно…
…И в этот момент я благоговейно улыбаюсь – как здорово, что все мы здесь сегодня собрались:
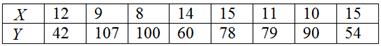
Имеются выборочные данные по студентам: – количество прогулов за некоторый период времени и – суммарная успеваемость за этот период:
И сразу обращаю внимание, что в условии приведены несгруппированные данные. Помимо этого варианта, есть задачи, где изначально дана комбинационная таблица, и их мы тоже разберём. Сначала одно, затем другое.
1) высказать предположение о наличии и направлении корреляционной зависимости признака-результата от признака-фактора и построить диаграмму рассеяния;
2) анализируя диаграмму рассеяния, сделать вывод о форме зависимости;
3) найти уравнение линейной регрессии на , выполнить чертёж;
4) вычислить линейный коэффициент корреляции, сделать вывод;
5) вычислить коэффициент детерминации, сделать вывод;
6) вычислить коэффициент эластичности и
7) вычислить бета-коэффициент, с выводами, понятное дело,
и для продвинутых читателей – проверка значимости линейной модели и иже с ней потрохами, а также вся анатомия.
Решение:
1) Прежде всего, повторим, что такое корреляционная зависимость. Очевидно, что чем больше студент прогуливает, тем более вероятно, что у него плохая успеваемость. Но всегда ли это так? Нет, не всегда. Успеваемость зависит от многих факторов. Один студент может посещать все пары, но все равно учиться посредственно, а другой – учиться неплохо даже при достаточно большом количестве прогулов. Однако общая тенденция состоит в том, что с увеличением количества прогулов средняя успеваемость студентов будет падать. Такая нежёсткая зависимость и называется корреляционной.
По своему направлению зависимость бывает прямой («чем больше, тем больше») и обратной («чем больше, тем меньше»). В данной задаче мы высказали предположение о наличии обратной корреляционной зависимости – успеваемости студентов от – количества их прогулов. И что немаловажно, обосновали причинно-следственную связь (читать всем. ) между признаками.
Проверить выдвинутое предположение проще всего графически, и в этом нам поможет:
диаграмма рассеяния
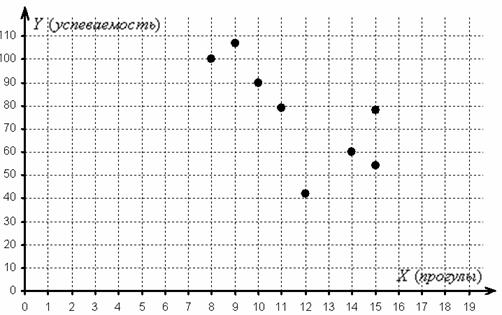
– это множество точек в декартовой системе координат, абсциссы которых соответствуют значениям признака-фактора , а ординаты – соответствующим значениям признака-результата . Минимальное количество точек должно равняться пяти-шести, в противном случае рассматриваемая задача превращается в профанацию. И мы «вписываемся в рамки» – объём выборки равен восьми студентам:
Обратите, кстати, внимание как раз на тот момент, что при одном и том же количестве прогулов (15) двое студентов имеют существенно разные результаты.
2) По диаграмме рассеяния хорошо видно, что с увеличением числа прогулов успеваемость преимущественно падает, что подтверждает наличие обратной корреляционной зависимости успеваемости от количества прогулов. Более того, почти все точки «выстроились» примерно по прямой, что даёт основание предположить, что данная зависимость близкА к линейной.
И здесь я анонсирую дальнейшие действия: сейчас нам предстоит найти уравнение прямой, ТАКОЙ, которая проходит максимально близко к эмпирическим точкам, а также оценить тесноту линейной корреляционной зависимости – насколько близко расположены эти точки к построенной прямой.
Технически существует два пути решения:
– сначала найти уравнение прямой и затем оценить тесноту зависимости;
– сначала найти тесноту и затем составить уравнение.
В практически задачах чаще встречается второй вариант, но я начну с первого, он более последователен. Построим:
3) уравнение линейной регрессии на
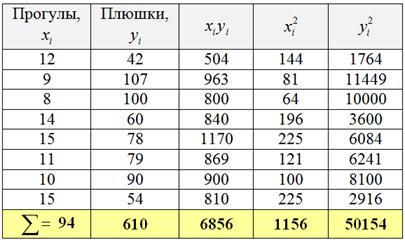
Это и есть та самая оптимальная прямая , которая проходит максимально близко к эмпирическим точкам. Обычно её находят методом наименьших квадратов, и мы пойдём знакомым путём. Заполним расчётную таблицу:
Обратите внимание, что в отличие от задач урока МНК у нас появился дополнительный столбец , он потребуется в дальнейшем, для расчёта коэффициента корреляции.
Коэффициенты функции найдём из решения системы:
Сократим оба уравнения на 2, всё попроще будет:
Систему решим по формулам Крамера:
, значит, система имеет единственное решение.
И проверка forever, подставим полученные значения в левую часть каждого уравнения исходной системы:
в результате получены соответствующие правые части, значит, система решена верно.
Таким образом, искомое уравнение регрессии:
Данное уравнение показывает, что с увеличением количества прогулов («икс») на 1 единицу суммарная успеваемость падает в среднем на 6,0485 – примерно на 6 баллов. Об этом нам рассказал коэффициент «а». И обратите особое внимание, что эта функция возвращает нам средние (среднеожидаемые) значения «игрек» для различных значений «икс».
Почему это регрессия именно « на » и о происхождении самого термина «регрессия» я рассказал чуть ранее, в параграфе эмпирические линии регрессии. Если кратко, то полученные с помощью уравнения средние значения успеваемости («игреки») регрессивно возвращают нас к первопричине – количеству прогулов. Вообще, регрессия – не слишком позитивное слово, но какое уж есть.
Найдём пару удобных точек для построения прямой:
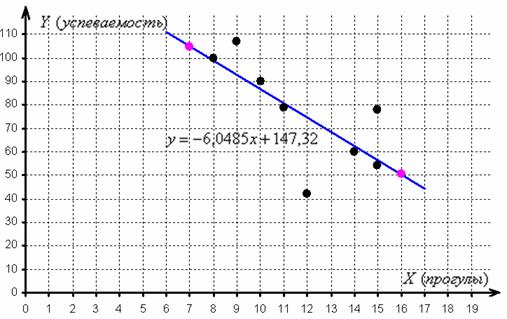
отметим их на чертеже (малиновый цвет) и проведём линию регрессии:
Говорят, что уравнение регрессии аппроксимирует (приближает) эмпирические данные (точки), и с помощью него можно интерполировать (оценить) неизвестные промежуточные значения, так при количестве прогулов среднеожидаемая успеваемость составит балла.
И, конечно, осуществимо прогнозирование, так при среднеожидаемая успеваемость составит баллов. Единственное, нежелательно брать «иксы», которые расположены слишком далеко от эмпирических точек, поскольку прогноз, скорее всего, не будет соответствовать действительности. Например, при значение может вообще оказаться невозможным, ибо у успеваемости есть свой фиксированный «потолок». И, разумеется, «икс» или «игрек» в нашей задаче не могут быть отрицательными.
Второй вопрос касается тесноты зависимости. Очевидно, что чем ближе эмпирические точки к прямой, тем теснее линейная корреляционная зависимость – тем уравнение регрессии достовернее отражает ситуацию, и тем качественнее полученная модель. И наоборот, если многие точки разбросаны вдали от прямой, то признак зависит от вовсе не линейно (если вообще зависит) и линейная функция плохо отражает реальную картину.
Прояснить данный вопрос нам поможет:
4) линейный коэффициент корреляции
Этот коэффициент как раз и оценивает тесноту линейной корреляционной зависимости и более того, указывает её направление (прямая или обратная). Его полное название: выборочный линейный коэффициент пАрной корреляции Пирсона 🙂
– «выборочный» – потому что мы рассматриваем выборочную совокупность;
– «линейный» – потому что он оценивает тесноту линейной корреляционной зависимости;
– «пАрной» – потому что у нас два признака (бывает хуже);
– и «Пирсона» – в честь английского статистика Карла Пирсона, это он автор понятия «корреляция».
И в зависимости от фантазии автора задачи вам может встретиться любая комбинация этих слов. Теперь нас не застанешь врасплох, Карл.
Линейный коэффициент корреляции вычислим по формуле:
, где: – среднее значение произведения признаков, – средние значения признаков и – стандартные отклонения признаков. Числитель формулы имеет особый смысл, о котором я расскажу, когда мы будем разбирать второй способ решения.
Осталось разгрести всё это добро 🙂 Впрочем, все нужные суммы уже рассчитаны в таблице выше. Вычислим средние значения:
Стандартные отклонения найдём как корни из соответствующих дисперсий, вычисленных по формуле:
Таким образом, коэффициент корреляции:
И расшифровка: коэффициент корреляции может изменяться в пределах и чем он ближе по модулю к единице, тем теснее линейная корреляционная зависимость – тем ближе расположены точки к прямой, тем качественнее и достовернее линейная модель. Если либо , то речь идёт о строгой линейной зависимости, при которой все эмпирические точки окажутся на построенной прямой. Наоборот, чем ближе к нулю, тем точки рассеяны дальше, тем линейная зависимость выражена меньше. Однако в последнем случае зависимость всё равно может быть! – например, нелинейной или какой-нибудь более загадочной. Но до этого мы ещё дойдём. А у кого не хватит сил, донесём 🙂
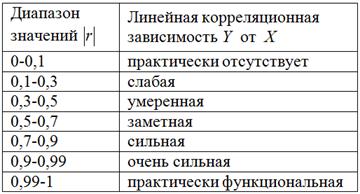
Для оценки тесноты связи будем использовать уже знакомую шкалу Чеддока:
При этом если , то корреляционная связь обратная, а если , то прямая.
В нашем случае , таким образом, существует сильная обратная линейная корреляционная зависимость – суммарной успеваемости от – количества прогулов.
Линейный коэффициент корреляции – это частный аналог эмпирического корреляционного отношения. Но в отличие от отношения, он показывает не только тесноту, но ещё и направление зависимости, ну и, конечно, здесь определена её форма (линейная).
5) Коэффициент детерминации
– это частный аналог эмпирического коэффициента детерминации – есть квадрат коэффициента корреляции:
– коэффициент детерминации показывает долю вариации признака-результата , которая обусловлена воздействием признака-фактора . С математическим обоснованием этого утверждения желающие могут ознакомиться в статье Однофакторная регрессия.
В нашей задаче:
– таким образом, в рамках построенной модели успеваемость на 51,74% зависит от количества прогулов. Оставшаяся часть вариации успеваемости (48,26%) обусловлена другими причинами.
! Примечание: но это не является какой-то «абсолютной истиной», это всего лишь оценка в рамках построенной модели.
Очевидно, что линейный коэффициент детерминации может изменяться в пределах , и чем он ближе к единице, тем удачнее линейная модель приближает эмпирические данные.
6) Вычислим коэффициент средней эластичности
Но сначала разберёмся, что такое эластичность. Это восприимчивость. Податливость. Представьте, что уровень тревожности в обществе увеличился на 1%. А Петя стал больше тревожиться всего на 0,3%. Таким образом, Петя неэластичен к тревожности. Маша в то же время стала тревожиться больше на 5%. Таким образом, Маша эластична к тревожности.
Иными словами, эластичность – это количество процентов, на которое изменяется признак-результат при увеличении признака-фактора на 1%. Если , то зависимый показатель неэластичен к воздействию признака-фактора. Если же – то эластичен.
Функция эластичности имеет вид: , где – функция регрессии, а – её производная. И в подавляющем большинстве случаев эластичность зависит от значения , так, для линейной регрессии получаем: – и мы можем вычислить эластичность в той или иной точке . Но чтобы не мучиться чаще рассчитывают средний коэффициент эластичности, по формуле: .
В нашей задаче: – таким образом, при увеличении количества прогулов на 1% успеваемость уменьшается в среднем на 0,93%.
Можно сказать, что эластичность близкА к нейтральной – количество прогулов растёт и успеваемость падает примерно такими же темпами. Хотя, повторюсь, при различных значениях эластичность будет разной: – вот вам почва для дополнительного исследования. И это особенно актуально, если «икс» может принимать как положительные, так и отрицательные значения, вследствие чего среднее значение эластичности только собьёт с толку. Следует добавить, что в некоторых задачах эластичность вообще не имеет содержательного смысла, хотя чисто формально рассчитать её можно.
7) Бета-коэффициент
Это ещё один относительный показатель влияния фактора на результат. «Бета» – это количество средних квадратических отклонений, на которое меняется признак-результат при увеличении признака-фактора на одно среднее квадратическое отклонение.
В чём смысл показателя? Давайте посмотрим на уравнение регрессии и конкретно на коэффициент . Вопрос: это много или мало? (с точки зрения влияния прогулов на успеваемость). И на самом деле ответ не очевиден. Если «а» очень великО по модулю, то это ещё не значит, что влияние существенно. И наоборот, «а» может составлять какие-то «жалкие» дробные доли, но влияние окажется ого-го! Всё относительно и всё зависит от колеблемости показателей, а эта самая колеблемость измеряется стандартными отклонениями. Которые и нужно сопоставить:
– таким образом, при увеличении количества прогулов на одно стандартное отклонение успеваемость уменьшается примерно на 0,72 своего стандартного отклонения.
Если какая-то причина сильно «надавливает» на следствие, то «бета» по модулю больше единицы , часто в разы больше. Если влияние умеренное, то . Ну а близкие к нулю значения говорят о практической невосприимчивости к фактору. В нашей задаче мы получили достаточно «сбалансированный» результат.
Задание выполнено
Но точку ставить рано. Теперь второй способ решения, в котором мы сначала находим коэффициент корреляции, а затем уравнение регрессии.
Линейный коэффициент корреляции вычислим по формуле:
, где – стандартные отклонения признаков .
Член в числителе называют корреляционным моментом или коэффициентом ковариации (совместной вариации) признаков, он рассчитывается следующим образом: , где – объём статистической совокупности, а – средние значения признаков. Данный коэффициент показывает, насколько согласованно отклоняются пАрные значения от своих средних в ту или иную сторону. Формулу можно упростить, в результате чего получится ранее использованная версия, без подробных выкладок: . Но сейчас мы пойдём другим путём.
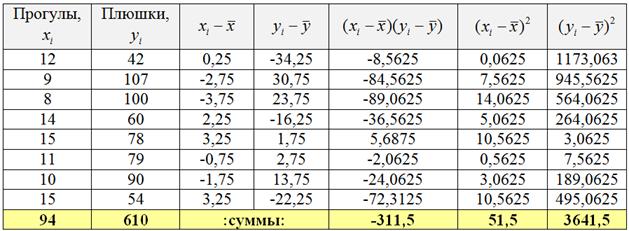
Заполним расчётную таблицу:
При этом сначала рассчитываем левые нижние суммы и средние значения признаков:
и только потом заполняем оставшиеся столбцы таблицы. О том, как быстро выполнить эти вычисления в Экселе, будет видео ниже!
Вычислим коэффициент ковариации:
.
Стандартные отклонения вычислим как квадратные корни из дисперсий:
Таким образом, коэффициент корреляции:
И если нам известны значения , то коэффициенты уравнения регрессии легко рассчитать по следующим формулам:
Таким образом, искомое уравнение:
Теперь смотрим ролик о том, как это всё быстро подсчитать и построить:

Как вычислить коэффициент корреляции и найти уравнение регрессии? (Ютуб)
Если под рукой нет Экселя, ничего страшного, разобранную задачу не так трудно решить в обычной клетчатой тетради. А если Эксель есть и времени нет, то можно воспользоваться моим калькулятором. Да, вы можете найти аналоги в Сети, но, скорее всего, это будет не совсем то, что нужно 😉
Какой способ решения выбрать? Ориентируйтесь на свой учебный план и методичку. По умолчанию лучше использовать 2-й способ, он несколько короче, и, вероятно, потому и встречается чаще. Кстати, если вам нужно построить ТОЛЬКО уравнение регрессии, то уместен 1-й способ, ибо там мы находим это уравнение в первую очередь.
Следующая задача много-много лет назад была предложена курсантам местной школы милиции (тогда ещё милиции), и это чуть ли не первая задача по теме, которая встретилась в моей профессиональной карьере. И я безмерно рад предложить её вам сейчас, разумеется, с дополнительными пунктами:)
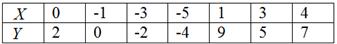
В результате независимых опытов получены 7 пар чисел:
…да, числа могут быть и отрицательными.
По данным наблюдений вычислить линейный коэффициент корреляции и детерминации, сделать выводы. Найти параметры линейной регрессии на , пояснить их смысл. Изобразить диаграмму рассеяния и график регрессии. Вычислить , что означают полученные результаты?
Из условия следует, что признак , очевидно, зависит от (ибо кто ж делает бессвязные опыты). Однако помните, что корреляционная зависимость и причинно-следственная связь – это не одно и то же! (прочитайте, если до сих пор не прочитали!). Поэтому, если в задаче просто предложены два числовых ряда (без контекста), то можно говорить лишь о зависимости корреляционной, но не о причинно-следственной.
Все данные уже забиты в Эксель, и вам осталось аккуратно выполнить расчёты. В образце я решил задачу вторым, более распространённым способом. И, конечно же, выполните проверку первым путём.
Следует отметить, что в целях экономии места я специально подобрал задачи с малым объёмом выборки. На практике обычно предлагают 10 или 20 пар чисел, реже 30, и максимальная выборка, которая мне встречалась в студенческих работах – 100. …Соврал малость, 80.
И сейчас я вас приглашаю на следующий урок, назову его Уравнение линейной регрессии, где мы рассчитаем и найдём всё то же самое – только для комбинационной группировки. Плюс немного глубже копнём уравнения регрессии (их два).
Решения и ответы:
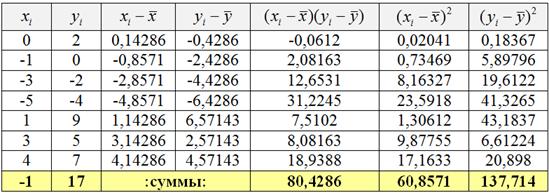
Пример 68. Решение: вычислим суммы и средние значения признаков , и заполним расчётную таблицу:
Вычислим коэффициент ковариации:
.
Вычислим средние квадратические отклонения:
Вычислим коэффициент корреляции:
, таким образом, существует сильная прямая корреляционная зависимость от.
Вычислим коэффициент детерминации:
– таким образом, 77,19% вариации признака обусловлено изменением признака . Остальная вариация (22,81%) обусловлена другими факторами.
Вычислим коэффициенты линейной регрессии :
Таким образом, искомое уравнение регрессии:
Данное уравнение показывает, что с увеличением значения «икс» на одну единицу «игрек» увеличивается в среднем примерно на 1,32 единицы (смысл коэффициента «а»).
При среднеожидаемое значение «игрек» составит примерно 2,62 ед. (смысл коэффициента «бэ»).
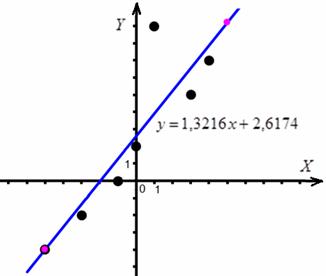
Найдём пару точек для построения прямой:
и выполним чертёж:
Вычислим:
– среднеожидаемое значение «игрек» при (интерполированный результат);
– среднеожидаемое значение «игрек» при (спрогнозированный результат).
Автор: Емелин Александр
(Переход на главную страницу)

Zaochnik.com – профессиональная помощь студентам,
cкидкa 15% на первый зaкaз, при оформлении введите прoмoкoд: 5530-hihi5
© Copyright mathprofi.ru, Александр Емелин, 2010-2023. Копирование материалов сайта запрещено
Расчет корреляционной матрицы в excel. Корреляционно-регрессионный анализ в Excel: инструкция выполнения
Давайте посчитаем их сами! Для примера, я решил попробовать посчитать корреляцию рубля к доллару через евро. Давайте разберем, как это делается подробно.
Эта статья рассчитана на продвинутый уровень владения Microsoft Excel. Если у вас нет времени читать всю статью, вы можете скачать файл и разобраться с ним самостоятельно.
Если вы часто сталкиваетесь с необходимостью сделать что-то подобное , настоятельно рекомендую подумать о покупке книги Статистические вычисления в среде Excel .
Чтобы рассчитать достоверную корреляцию, необходимо иметь достоверную выборку, чем больше она будет, тем достовернее будет результат. Для целей данного примера я взял ежедневную выборку курсов валют за 10 лет. Данные есть в свободном доступе, я их брал с сайта http://oanda.com .
(2) Мне это показалось очень странным. Какие ошибки могли закрасться в мои расчеты? Поэтому я решил построить график и посмотреть, что могло произойти. График был простоен специально с разбивкой по годам, чтобы можно было визуально увидеть, где рвет корреляцию. График получился вот таким

(3) Из графика очевидно, что на диапазоне около 35 рублей за евро корреляцию начинает рвать на две части. Из-за этого она и получилась недостоверной. Необходимо было определить в связи с чем это происходит.
Теоретически, функцию корреляции можно уточнить, если перевести ее из линейной в экспоненциальную или логарифмическую. При этом статистическая достоверность корреляции вырастает приблизительно на один процент, но сложность применения формулы повышается неимоверно. Поэтому для себя я ставлю вопрос: а нужно ли это на самом деле? Решать вам — для каждого конкретного случая.
При корреляционной связи одной и той же величине одного признака соответствуют разные величины другого. Например: между ростом и весом имеется корреляционная связь, между заболеваемостью злокачественными новообразованиямии возрастом и т.д.
Существует 2 метода вычисления коэффициента корреляции: метод квадратов(Пирсона), метод рангов (Спирмена).
Наиболее точным является метод квадратов (Пирсона), при котором коэффициент корреляции определяется по формуле: , где
r ху ― коэффициент корреляции между статистическим рядом X и Y.
d х ― отклонение каждого из чисел статистического ряда X от своей средней арифметической.
d у ― отклонение каждого из чисел статистического ряда Y от своей средней арифметической.
В зависимости от силы связи и ее направления коэффициент корреляции может находиться в пределах от 0 до 1 (-1). Коэффициент корреляции, равный 0, говорит о полном отсутствии связи. Чем ближе уровень коэффициента корреляции к 1 или (-1), тем соответственно больше, теснее измеряемая им прямая или обратная связь. При коэффициенте корреляции равном 1 или (-1) связь полная, функциональная.
Схема оценки силы корреляционной связи по коэффициенту корреляции
Для вычисления коэффициента корреляции по методу квадратов составляется таблица из 7 колонок. Разберем процесс вычисления на примере:
3. Определяем отклонение каждого V x от М x , т.е. d x .
4. Аналогично определяем отклонение каждого V у от M у, т.е. d у.
5. Определяем произведения отклонений. Полученное произведение суммируем и получаем.
6. d х возводим в квадрат и результаты суммируем, получаем.
7. Аналогично возводим в квадрат d у, результаты суммируем, получим

8. Наконец, все полученные суммы подставляем в формулу:
Для решения вопроса о достоверности коэффициента корреляции определяют его среднюю ошибку по формуле:

(Если число наблюдений менее 30, тогда в знаменателе n–1).
Величина коэффициента корреляции считается достоверной, если не менее чем в 3 раза превышает свою среднюю ошибку.

В нашем примере
Таким образом, коэффициент корреляции не достоверен, что вызывает необходимость увеличения числа наблюдений.
Коэффициент корреляции можно определить несколько менее точным, но намного более легким способом ― методом рангов (Спирмена).
составить два ряда из парных сопоставляемых признаков, обозначив первый и второй ряд соответственно х и у. При этом представить первый ряд признака в убывающем или возрастающем порядке, а числовые значения второго ряда расположить напротив тех значений первого ряда, которым они соответствуют
получить сумму квадратов разности (Σ d 2) и подставить полученные значения в формулу:
Пример: методом рангов установить направление и силу связи между стажем работы в годах и частотой травм, если получены следующие данные:
Обоснование выбора метода: для решения задачи может быть выбран только метод ранговой корреляции, т.к. первый ряд признака «стаж работы в годах» имеет открытые варианты (стаж работы до 1 года и 7 и более лет), что не позволяет использовать для установления связи между сопоставляемыми признаками более точный метод — метод квадратов.
Решение . Последовательность расчетов изложена в тексте, результаты представлены в табл. 2.
Каждый из рядов парных признаков обозначить через «х» и через «у» (графы 1-2).
Разность рангов возвести в квадрат (d 2) и получить сумму квадратов разности рангов Σ d 2 (графа 6).
Произвести расчет коэффициента ранговой корреляции по формуле:
где n — число сопоставляемых пар вариант в ряду «x» и в ряду «у»
Коэффициент корреляции отражает степень взаимосвязи между двумя показателями. Всегда принимает значение от -1 до 1. Если коэффициент расположился около 0, то говорят об отсутствии связи между переменными.
Расчет коэффициента корреляции в Excel
Рассмотрим на примере способы расчета коэффициента корреляции, особенности прямой и обратной взаимосвязи между переменными.
Y – независимая переменная, x – зависимая. Необходимо найти силу (сильная / слабая) и направление (прямая / обратная) связи между ними. Формула коэффициента корреляции выглядит так:
Чтобы упростить ее понимание, разобьем на несколько несложных элементов.
Между переменными определяется сильная прямая связь.
Встроенная функция КОРРЕЛ позволяет избежать сложных расчетов. Рассчитаем коэффициент парной корреляции в Excel с ее помощью. Вызываем мастер функций. Находим нужную. Аргументы функции – массив значений y и массив значений х:

Видна сильная связь между y и х, т.к. линии идут практически параллельно друг другу. Взаимосвязь прямая: растет y – растет х, уменьшается y – уменьшается х.
Матрица парных коэффициентов корреляции в Excel
Корреляционная матрица представляет собой таблицу, на пересечении строк и столбцов которой находятся коэффициенты корреляции между соответствующими значениями. Имеет смысл ее строить для нескольких переменных.

Матрица коэффициентов корреляции в Excel строится с помощью инструмента «Корреляция» из пакета «Анализ данных».
Между значениями y и х1 обнаружена сильная прямая взаимосвязь. Между х1 и х2 имеется сильная обратная связь. Связь со значениями в столбце х3 практически отсутствует.
Начнём с того, что такое коэффициент корреляции вообще. Он показывает степень взаимосвязи между двумя элементами и всегда находится в диапазоне от -1 (сильная обратная взаимосвязь) до 1 (сильная прямая взаимосвязь). Если коэффициент равен 0, это говорит о том, что взаимосвязь между значениями отсутствует.
Теперь, когда есть все необходимые данные, можно посчитать корреляцию. Перемножьте полученные разности таким образом: (x-x ср) * (y-y ср). После того как вы получите результат для каждой из переменных, просуммируйте полученные числа при помощи функции автосуммы. Таким образом рассчитывается числитель.
В научных исследованиях часто возникает необходимость в нахождении связи между результативными и факторными переменными (урожайностью какой-либо культуры и количеством осадков, ростом и весом человека в однородных группах по полу и возрасту, частотой пульса и температурой тела и т.д.).
Вторые представляют собой признаки, способствующие изменению таковых, связанных с ними (первыми).
Понятие о корреляционном анализе
Существует множество Исходя из вышеизложенного, можно сказать, что корреляционный анализ — это метод, применяющийся с целью проверки гипотезы о статистической значимости двух и более переменных, если исследователь их может измерять, но не изменять.
Понятие о ложности корреляции
При проведении корреляционного анализа необходимо учитывать, что его можно провести по отношению к любой совокупности признаков, зачастую абсурдных по отношению друг к другу. Порой они не имеют никакой причинной связи друг с другом.
Задачи корреляционного анализа
Исходя из приведенных выше определений, можно сформулировать следующие задачи описываемого метода: получить информацию об одной из искомых переменных с помощью другой; определить тесноту связи между исследуемыми переменными.
Корреляционный анализ предполагает определение зависимости между изучаемыми признаками, в связи с чем задачи корреляционного анализа можно дополнить следующими:
- выявление факторов, оказывающих наибольшее влияние на результативный признак;
- выявление неизученных ранее причин связей;
- построение корреляционной модели с ее параметрическим анализом;
- исследование значимости параметров связи и их интервальная оценка.
Связь корреляционного анализа с регрессионным
Условия использования метода

Правила отбора факторов корреляционного анализа
Отображение результатов
Результаты корреляционного анализа могут быть представлены в текстовом и графическом видах. В первом случае они представляются как коэффициент корреляции, во втором — в виде диаграммы разброса.

Трехмерное представление диаграммы разброса (рассеивания)
Помимо традиционного 2D-представления диаграммы разброса в настоящее время используется 3D-отображение графического представления корреляционного анализа.


Оценка тесноты связи
Теснота корреляционной связи определяется по коэффициенту корреляции (r): сильная — r = ±0,7 до ±1, средняя — r = ±0,3 до ±0,699, слабая — r = 0 до ±0,299. Данная классификация не является строгой. На рисунке показана несколько иная схема.

Пример применения метода корреляционного анализа
В Великобритании было предпринято любопытное исследование. Оно посвящено связи курения с раком легких, и проводилось путем корреляционного анализа. Это наблюдение представлено ниже.
Работники печей, кузнечных, литейных и прокатных станов
Работники пищевой, питьевой и табачной промышленности
Складские рабочие, кладовщики, упаковщики и работники разливочных машин
Начинаем корреляционный анализ. Решение лучше начинать для наглядности с графического метода, для чего построим диаграмму рассеивания (разброса).

Она демонстрирует прямую связь. Однако на основании только графического метода сделать однозначный вывод сложно. Поэтому продолжим выполнять корреляционный анализ. Пример расчета коэффициента корреляции представлен ниже.
Использование ПО при проведении корреляционного анализа
Описываемый вид статистической обработки данных может осуществляться с помощью программного обеспечения, в частности, MS Excel. Корреляционный предполагает вычисление следующих парамет-ров с использованием функций:
1. Коэффициент корреляции определяется с помощью функции КОРРЕЛ (массив1; массив2). Массив1,2 — ячейка интервала значений результативных и факторных переменных.
Линейный коэффициент корреляции также называется коэффициентом корреляции Пирсона, в связи с чем, начиная с Excel 2007, можно использовать функцию с теми же массивами.
Графическое отображение корреляционного анализа в Excel производится с помощью панели «Диаграммы» с выбором «Точечная диаграмма».
В заключение
Использование в научных исследованиях метода корреляционного анализа позволяет определить связь между различными факторами и результативными показателями. При этом необходимо учитывать, что высокий коэффициент корреляции можно получить и из абсурдной пары или множества данных, в связи с чем данный вид анализа нужно осуществлять на достаточно большом массиве данных.

[expert_bq иногда нулевая корреляция возникает, если сделана неудачная выборка, которая не отразила связь, либо связь имеет сложный нелинейный характер. Если же вы хотите что-то уточнить, обращайтесь ко мне![/expert_bq] Анализируя диаграмму рассеяния можно заметить, что точки на ней расположены как бы в линию, следовательно, линейное уравнение парной регрессии y=a+b∙x, скорее всего, будет хорошо описывать данную ситуацию.
Как построить график корреляции в excel — Все про Эксель
- выявление факторов, оказывающих наибольшее влияние на результативный признак;
- выявление неизученных ранее причин связей;
- построение корреляционной модели с ее параметрическим анализом;
- исследование значимости параметров связи и их интервальная оценка.
Она демонстрирует прямую связь. Однако на основании только графического метода сделать однозначный вывод сложно. Поэтому продолжим выполнять корреляционный анализ. Пример расчета коэффициента корреляции представлен ниже.
Функция корреляции в excel
Функция КОРРЕЛ Возвращает коэффициент корреляции двух диапазонов ячеек. Коэффициент корреляции используется для определения взаимосвязи между двумя свойствами. Например, можно установить зависимость между средней температурой в помещении и использованием кондиционера.
Синтаксис
аргумент — обязательный аргумент. Диапазон значений ячеек.
Массив2 — обязательный аргумент. Второй диапазон значений ячеек.
Замечания
Если аргумент, который является массивом или ссылкой, содержит текст, логические значения или пустые ячейки, то такие значения игнорируются; Тем не менее, ячейки, содержащие нулевые значения, учитываются.
Если аргумент “массив1” и “массив2” имеют различное количество точек данных, КОРРЕЛ возвращает ошибку #N/A.
Если аргумент массив1 или массив2 пуст или если ( стандартное отклонение) их значений равны нулю, КОРРЕЛ возвращает значение #DIV/0! Если позиция, которую вы указали, находится перед первым или после последнего элемента в поле, формула возвращает ошибку #ССЫЛКА!.
Так как коэффициент корреляции ближе к + 1 или-1, он указывает на положительную (+ 1) или отрицательную (-1) корреляцию между массивами. Положительная корреляция означает, что если значения в одном массиве увеличиваются, значения в другом массиве также увеличиваются. Коэффициент корреляции, который ближе к 0, указывает на то, что корреляция не является надежной.
Уравнение для коэффициента корреляции имеет следующий вид:
являются средними значениями выборок СРЗНАЧ(массив1) и СРЗНАЧ(массив2).
Пример
В следующем примере возвращается коэффициент корреляции двух наборов данных в столбцах A и B.

Дополнительные сведения
Вы всегда можете задать вопрос специалисту Excel Tech Community, попросить помощи в сообществе Answers community, а также предложить новую функцию или улучшение на веб-сайте Excel User Voice.
Примечание: Эта страница переведена автоматически, поэтому ее текст может содержать неточности и грамматические ошибки. Для нас важно, чтобы эта статья была вам полезна. Была ли информация полезной? Для удобства также приводим ссылку на оригинал (на английском языке).
2 способа корреляционного анализа в Microsoft Excel
Корреляционный анализ – популярный метод статистического исследования, который используется для выявления степени зависимости одного показателя от другого. В Microsoft Excel имеется специальный инструмент, предназначенный для выполнения этого типа анализа. Давайте выясним, как пользоваться данной функцией.
Суть корреляционного анализа
Предназначение корреляционного анализа сводится к выявлению наличия зависимости между различными факторами. То есть, определяется, влияет ли уменьшение или увеличение одного показателя на изменение другого.
Расчет коэффициента корреляции
Теперь давайте попробуем посчитать коэффициент корреляции на конкретном примере. Имеем таблицу, в которой помесячно расписана в отдельных колонках затрата на рекламу и величина продаж. Нам предстоит выяснить степень зависимости количества продаж от суммы денежных средств, которая была потрачена на рекламу.
Способ 1: определение корреляции через Мастер функций
Одним из способов, с помощью которого можно провести корреляционный анализ, является использование функции КОРРЕЛ. Сама функция имеет общий вид КОРРЕЛ(массив1;массив2).
-
Выделяем ячейку, в которой должен выводиться результат расчета. Кликаем по кнопке «Вставить функцию», которая размещается слева от строки формул.
Открывается окно аргументов функции. В поле «Массив1» вводим координаты диапазона ячеек одного из значений, зависимость которого следует определить. В нашем случае это будут значения в колонке «Величина продаж». Для того, чтобы внести адрес массива в поле, просто выделяем все ячейки с данными в вышеуказанном столбце.
В поле «Массив2» нужно внести координаты второго столбца. У нас это затраты на рекламу. Точно так же, как и в предыдущем случае, заносим данные в поле.
Как видим, коэффициент корреляции в виде числа появляется в заранее выбранной нами ячейке. В данном случае он равен 0,97, что является очень высоким признаком зависимости одной величины от другой.
Способ 2: вычисление корреляции с помощью пакета анализа
Кроме того, корреляцию можно вычислить с помощью одного из инструментов, который представлен в пакете анализа. Но прежде нам нужно этот инструмент активировать.
В открывшемся окне перемещаемся в раздел «Параметры».
В нижней части следующего окна в разделе «Управление» переставляем переключатель в позицию «Надстройки Excel», если он находится в другом положении. Жмем на кнопку «OK».
В окне надстроек устанавливаем галочку около пункта «Пакет анализа». Жмем на кнопку «OK».
После этого пакет анализа активирован. Переходим во вкладку «Данные». Как видим, тут на ленте появляется новый блок инструментов – «Анализ». Жмем на кнопку «Анализ данных», которая расположена в нем.
Открывается список с различными вариантами анализа данных. Выбираем пункт «Корреляция». Кликаем по кнопке «OK».
Открывается окно с параметрами корреляционного анализа. В отличие от предыдущего способа, в поле «Входной интервал» мы вводим интервал не каждого столбца отдельно, а всех столбцов, которые участвуют в анализе. В нашем случае это данные в столбцах «Затраты на рекламу» и «Величина продаж».
Параметр «Группирование» оставляем без изменений – «По столбцам», так как у нас группы данных разбиты именно на два столбца. Если бы они были разбиты построчно, то тогда следовало бы переставить переключатель в позицию «По строкам».
В параметрах вывода по умолчанию установлен пункт «Новый рабочий лист», то есть, данные будут выводиться на другом листе. Можно изменить место, переставив переключатель. Это может быть текущий лист (тогда вы должны будете указать координаты ячеек вывода информации) или новая рабочая книга (файл).
Так как место вывода результатов анализа было оставлено по умолчанию, мы перемещаемся на новый лист. Как видим, тут указан коэффициент корреляции. Естественно, он тот же, что и при использовании первого способа – 0,97. Это объясняется тем, что оба варианта выполняют одни и те же вычисления, просто произвести их можно разными способами.
Как видим, приложение Эксель предлагает сразу два способа корреляционного анализа. Результат вычислений, если вы все сделаете правильно, будет полностью идентичным. Но, каждый пользователь может выбрать более удобный для него вариант осуществления расчета.
Отблагодарите автора, поделитесь статьей в социальных сетях.
ITGuides.ru
Вопросы и ответы в сфере it технологий и настройке ПК
Как выполняется корреляция в Excel?
Использование корреляции
Вычисление корреляции особенно широко используется в экономике, социологических исследованиях, медицине и биометрии — везде, где можно получить два массива данных, между которыми может обнаружиться связь.
Как выполнить корреляцию в Excel?
Самым трудоемким этапом определения корреляции является набор массива данных. Сравниваемые данные располагаются обычно в двух колонках или строчках. Таблицу следует делать без пропусков в ячейках. Современные версии Excel (с 2007 и младше) не требуют установок дополнительных настроек для статистических расчетов; необходимые манипуляции можно сделать в разделе формул:
- Выбрать пустую ячейку, в которую будет выведен результат расчетов.
- Нажать в главном меню Excel пункт «Формулы».
- Среди кнопок, сгруппированных в «Библиотеку функций», выбрать «Другие функции».
- В выпадающих списках выбрать функцию расчета корреляции (Статистические — КОРРЕЛ).
- В Excel откроется панель «Аргументы функции». «Массив 1» и «Массив 2» — это диапазоны сравниваемых данных. Для автоматического заполнения этих полей можно просто выделить нужные ячейки таблицы.
- Нажать «ОК», закрыв окно аргументов функции. В ячейке появится подсчитанный коэффициент корреляции.
Корреляция может быть прямая (если коэффициент больше нуля) и обратная (от -1 до 0).
Первая означает, что при росте одного параметра растет и другой. Обратная (отрицательная) корреляция отражает факт, что при росте одной переменной другая уменьшается.
Корреляция может быть близка к нулю. Это обычно свидетельствует, что исследуемые параметры не связаны друг с другом. Но иногда нулевая корреляция возникает, если сделана неудачная выборка, которая не отразила связь, либо связь имеет сложный нелинейный характер.
Отблагодари меня, поделись ссылкой с друзьями в социальных сетях:
Функция КОРРЕЛ для определения взаимосвязи и корреляции в Excel
Функция КОРРЕЛ в Excel используется для расчета коэффициента корреляции между для двух исследуемых массивов данных и возвращает соответствующее числовое значение.
Примеры использования функции КОРРЕЛ в Excel
Пример 1. В таблице Excel содержатся данные о курсе доллара и средней зарплате сотрудников фирмы на протяжении нескольких лет. Определить взаимосвязь между курсом валюты и средней зарплатой.


Полученный результат близок к 1 и свидетельствует о сильной прямой взаимосвязи между исследуемыми величинами. Однако прямо пропорциональной зависимости между ними нет, то есть на увеличение средней зарплаты оказывали влияние и прочие факторы.
Определение коэффициента корреляции влияния действий на результат

Произведем расчет коэффициентов корреляции с помощью формул:

Анализ популярности контента по корреляции просмотров и репостов видео
Определим наличие взаимосвязи между двумя параметрами по формуле:
0,7;ЕСЛИ(КОРРЕЛ(A3:A8;B3:B8)>0,7;”Сильная прямая зависимость”;”Сильная обратная зависимость”);”Слабая зависимость или ее отсутствие”)’ >
Если модуль коэффициента корреляции больше 0,7, считается рациональным использование функции линейной регрессии (y=ax+b) для описания связи между двумя величинами. В данном случае:

Построим график зависимости числа просмотров от количества репостов, отобразим линию тренда и ее уравнение:

Используем данное уравнение для определения количества просмотров при 200, 500 и 1000 репостов:

Аналогичное уравнение использует функция ПРЕДСКАЗ. То есть, чтобы найти количество просмотров в случае, если было сделано, например, 250 репостов, можно использовать формулу:

Коэффициент корреляции – один из множества статистических критериев определения наличия взаимосвязи между двумя рядами значений. Для построения точных статистических моделей рекомендуется использовать дополнительные параметры, такие как коэффициент детерминации, стандартная ошибка и другие.
Особенности использования функции КОРРЕЛ в Excel
- массив1 – обязательный аргумент, содержащий диапазон ячеек или массив данных, которые характеризуют изменения свойства какого-либо объекта.
- массив2 – обязательный аргумент (диапазон ячеек либо массив), элементы которого характеризуют изменение свойств второго объекта.
Примечание 2: Коэффициент корреляции представляет собой количественную характеристику степени взаимосвязи между двумя свойствами объектов. Этот коэффициент может принимать значения из диапазона от -1 до 1, при этом:
- Если значение коэффициента приближается к 1 или -1, между двумя исследуемыми свойствами существует сильная прямая или обратная взаимосвязи соответственно.
- Если значение коэффициента стремится к 0,5 или -0,5, два свойства слабо прямо или обратно взаимосвязаны друг с другом соответственно.
- Если коэффициент корреляции близок к 0 (нулю), между двумя исследуемыми свойствами отсутствует прямая либо обратная взаимосвязи.
Примечание 3: Для понимания смысла коэффициента корреляции можно привести два простых примера:
- При нагреве вещества количество теплоты, содержащееся в нем, будет увеличиваться. То есть, между температурой и количеством теплоты (физическая величина) существует прямая взаимосвязь.
- При увеличении стоимости продукции спрос на нее уменьшается. То есть, между ценой и покупательной способностью существует обратная взаимосвязь.
Коэффициент корреляция в excel — примеры как применять
Microsoft Office Excel часто используется для анализа данных и применения различных функций, которые встроены в программу. Для выявления зависимости одной величины от другой ведутся корреляционные исследования, которые достаточно популярны в статистике. Сегодня разберемся, как осуществляется корреляция в excel.
Введение
Чтобы рассчитать коэффициент корреляции, необходимо воспользоваться специальной функцией КОРРЕЛ. Формула содержит аргументы для двух массивов данных, между которыми нужно найти зависимость. Полученный коэффициент корреляции в excel можно расшифровать следующим образом:
- Если значение близко к 1 или -1, то существует сильная прямая или обратная связь между величинами.
- Коэффициент около 0,5 или -0,5 говорит о том, что между массивами слабая взаимосвязь.
- Если получается число близкое к нулю, то величины не связаны между собой.
При этом есть ряд особенностей использования функции КОРРЕЛ:
- Программа не учитывает в расчете пустые ячейки, элементы массива с текстовым форматом и ячейки с логическими операторами. При этом числа в виде текста будут учтены.
- Размеры двух массивов должны быть одинаковыми, в противном случае редактор выдаст ошибку типа Н/Д.
- При корреляционном анализе нельзя использовать пустые столбцы или диапазон с нулевыми значениями.
Примеры использования
Рассмотрим несколько задач, чтобы понять принцип работы статистической функции.
Пример 1. В фирме есть бюджет на рекламную кампанию в месяц, а также есть объем продаж продукта, необходимо посчитать зависимость этих величин.

В произвольной ячейке записываете формулу со ссылкой на два диапазона и получаете число.

Результат близок к единице, значит между рекламой и продажами продукта существует сильная прямая зависимость.
Пример 2.
Есть показатели продаж мебели за квартал, а также изменение цены на товар за тот же период времени.

В данном случае коэффициент корреляции стремится к -1, что говорит о сильной обратной зависимости. То есть с увеличением цены товара, продажи падают.
Пример 3.
Имеются затраты на квартиру и еду за три месяца, необходимо вычислить зависимость этих статей расхода друг от друга.

Полученный результат говорит о слабой связи этих категорий.
Прочие возможности
Также можно сделать график, чтобы наглядно показать зависимость одной величины от другой. Сделаем это для первого примера с рекламой и продажами.

Такой способ отображения данных позволяет быстро оценить влияние, а коэффициент корреляции отображает силу зависимости. Однако делать окончательный вывод на основе корреляционных исследований не рекомендуется, необходимо проводить дополнительный анализ влияющих факторов.
Как видите, редактор Excel от Microsoft позволяет проводить статистические исследования и выявлять взаимосвязи между массивами данных при помощи встроенных функций. Корреляция дает общее представление о взаимосвязи данных, но более точные результаты можно получить только с использованием нескольких статистических инструментов.
Жми «Нравится» и получай только лучшие посты в Facebook ↓
Как найти корреляцию в Excel
Начнём с того, что такое коэффициент корреляции вообще. Он показывает степень взаимосвязи между двумя элементами и всегда находится в диапазоне от -1 (сильная обратная взаимосвязь) до 1 (сильная прямая взаимосвязь). Если коэффициент равен 0, это говорит о том, что взаимосвязь между значениями отсутствует.
Теперь, когда есть все необходимые данные, можно посчитать корреляцию. Перемножьте полученные разности таким образом: (x-xср) * (y-yср). После того как вы получите результат для каждой из переменных, просуммируйте полученные числа при помощи функции автосуммы. Таким образом рассчитывается числитель.
[expert_bq ранее рассматривали корреляцию вплоть до 1, но как видите на практике даже совпадение в районе 20-30 уже говорит о некоторой схожести ПАММ-счетов и, как следствие, результатов торговли. Если же вы хотите что-то уточнить, обращайтесь ко мне![/expert_bq] Несмотря на то, что каждый из активов обладает определенным риском, портфель получился фактически безрисковым. Какая-то магия, не правда ли? Очень жаль, но на практике такого не бывает, иначе инвестирование было бы слишком лёгким занятием.
Коэффициент корреляции: формулы и пример расчета Excel
- Если значение близко к 1 или -1, то существует сильная прямая или обратная связь между величинами.
- Коэффициент около 0,5 или -0,5 говорит о том, что между массивами слабая взаимосвязь.
- Если получается число близкое к нулю, то величины не связаны между собой.
Предназначение корреляционного анализа сводится к выявлению наличия зависимости между различными факторами. То есть, определяется, влияет ли уменьшение или увеличение одного показателя на изменение другого.