Unstable Diffusion — вышла бесплатная нейросеть для рисования тянок (и не только)! + минигайд
Это свершилось! Качественная нейросеть изображений (особо хорошо натренирована на NSFW контенте) которая работает абсолютно бесплатно, в России, да еще и без цензуры!
Что такое Unstable Diffusion?
Примерно в то же время что и начало взлета нейросети Midjourney появился подобный дискорд сервер со своей нейросетью которая была особо натренированна на NSFW контент, не имела практически никакой цензуры и самое главное была абсолютно бесплатна!
Очень быстро серверы стали не выдерживать, создатели начали собирать на кикстартере деньги на улучшение нейронки, но кампанию быстро прикрыли и хотели вообще засудить нейронку ведь там можно создавать очень реалистичную дичь любого рода.
Но похоже все судебные иски они смогли оспорить и продолжили развивать свое детище, и вот спустя много месяцев они не только опять открыли свою нейронку бесплатно для всех, но и сделали удобный сайт для ввода параметров с историей генерации! Сразу скажу что пусть вас не смущает то что это нейросеть вроде как чисто для NSFW, это не так! Она может очень достойно рисовать практически что угодно почти не уступая какой-нибудь Midjourney и если вы не захотите то никогда не увидите ничего непристойного на их сервере и сами такого случайно никогда не создадите!
Saved searches
Use saved searches to filter your results more quickly
Cancel Create saved search
You signed in with another tab or window. Reload to refresh your session. You signed out in another tab or window. Reload to refresh your session. You switched accounts on another tab or window. Reload to refresh your session.
Have a question about this project? Sign up for a free GitHub account to open an issue and contact its maintainers and the community.
By clicking “Sign up for GitHub”, you agree to our terms of service and privacy statement. We’ll occasionally send you account related emails.
Already on GitHub? Sign in to your account
[Bug]: the /queue/status api return Internal Server Error #4197
LeeSenBLVER opened this issue Nov 3, 2022 · 4 comments
[Bug]: the /queue/status api return Internal Server Error #4197
LeeSenBLVER opened this issue Nov 3, 2022 · 4 comments
bug-report Report of a bug, yet to be confirmed
Comments
LeeSenBLVER commented Nov 3, 2022
Is there an existing issue for this?
- I have searched the existing issues and checked the recent builds/commits
What happened?
when i startup sd-webui with —api —lishen, i execute /queue/status api, then i got a «Interal Server Error» response
Steps to reproduce the problem
- edit webui-user.bat, set COMMANDLINE_ARGS=—listen —ckpt animefull-final-pruned.ckpt —port 7860 —api
- run webui-user.bat
- open http://127.0.0.1:7860/docs
- execute /quque/status api
What should have happened?
it should return the successful response, like
Commit where the problem happens
What platforms do you use to access UI ?
What browsers do you use to access the UI ?
Command Line Arguments
--listen --ckpt animefull-final-pruned.ckpt --port 7860 --api
Additional information, context and logs
ERROR: Exception in ASGI application
Traceback (most recent call last):
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\uvicorn\protocols\http\h11_impl.py», line 407, in run_asgi
result = await app( # type: ignore[func-returns-value]
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\uvicorn\middleware\proxy_headers.py», line 78, in call
return await self.app(scope, receive, send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\fastapi\applications.py», line 270, in call
await super().call(scope, receive, send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\applications.py», line 124, in call
await self.middleware_stack(scope, receive, send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\middleware\errors.py», line 184, in call
raise exc
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\middleware\errors.py», line 162, in call
await self.app(scope, receive, _send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\middleware\gzip.py», line 24, in call
await responder(scope, receive, send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\middleware\gzip.py», line 43, in call
await self.app(scope, receive, self.send_with_gzip)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\middleware\cors.py», line 84, in call
await self.app(scope, receive, send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\middleware\exceptions.py», line 75, in call
raise exc
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\middleware\exceptions.py», line 64, in call
await self.app(scope, receive, sender)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\fastapi\middleware\asyncexitstack.py», line 21, in call
raise e
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\fastapi\middleware\asyncexitstack.py», line 18, in call
await self.app(scope, receive, send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\routing.py», line 680, in call
await route.handle(scope, receive, send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\routing.py», line 275, in handle
await self.app(scope, receive, send)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\starlette\routing.py», line 65, in app
response = await func(request)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\fastapi\routing.py», line 231, in app
raw_response = await run_endpoint_function(
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\fastapi\routing.py», line 160, in run_endpoint_function
return await dependant.call(**values)
File «E:\work\stable-diffusion-webui-master\venv\lib\site-packages\gradio\routes.py», line 339, in get_queue_status
return app.blocks._queue.get_estimation()
AttributeError: ‘Blocks’ object has no attribute ‘_queue’
The text was updated successfully, but these errors were encountered:
Как пользоваться нейросетью Stable Diffusion
Если вы, как и я, не имеете доступа к DALL·E 2, уже потратили свои попытки с Midjourney, а продолжать генерировать изображения хочется.
«Grant Theft Democracy» от volksvargas
0. Дисклеймер
Вся информация в этом гайде (и часть картинок) взята с разных постов реддита r/StableDiffusion. Рекомендую отслеживать его, если хотите быть в курсе появляющихся новых возможностей программы, найденных лайфхаках для генерации или если у вас появляется вопрос, с которым не помогает гугл.
В этом гайде я в основном описываю шаги, которых будет достаточно пользователю на Windows с видеокартами Nvidia 10XX с 4-6 гигабайтами видеопамяти и выше для запуска на своем компе. Если у вас мощная карта от красных — возможно, вам поможет вот этот гайд.
Все меняется крайне быстро и я не гарантирую, что все шаги будут актуальны через неделю-другую.
1. Введение. Что еще за Stable Diffusion?
Stable Diffusion — программа с открытым исходным кодом от группы Stability.Ai , выпущенная в публичный доступ 22 августа, состоит из 2х больших частей — собственно, обученной нейросети (сейчас доступна версия 1.4, скоро будет доступна 1.5 — в ней обещают более качественные лица/глаза/руки) и обвязки, ее вызывающей.
Результаты ее работы похожи на DALL·E и Midjourney (мне с друзьями показалось, что в среднем Midjourney рисует чуть выразительнее, а Stable Diffusion более четко следует запросу при настройках по умолчанию), главное преимущество с точки зрения пользователя сейчас — нет ограничений на генерируемые изображения (NSWF фильтр есть в оригинале, но легко снимается) и все бесплатно.
«Бесплатно», запрос от меня — Ryan Gosling smiling, symmetric highly detailed eyes, trending on artstation, portrait, digital art, masterpice, by Vladimir Kush and Scott Naismith
Сообщество растет быстро и уже сейчас есть куча разных вариантов работы с нейросетью:
- Базовый — через консоль. Для тех, кто не боится python и/или чуть-чуть потрогать код. Если готовы — выкачиваете с гитхаба подходящий вам по каким-то соображениям вариант (Исходный вот тут ; вариант для запуска с меньшими затратами видеопамяти и кучей дополнительных опций — тут) и следуете гайду по настройке окружения/запуска (для исходника — вот, для второго варианта — вот). Плюсы — вам проще будет интегрировать новые появляющиеся методы генерации изображений и вы чуть лучше разберетесь в том, как это все работает.
- Через браузер (например, на этом сайте без регистрации и настроек , на этом — с регистрацией и разными настройками ). Плюсы — доступно с любого устройства и ничего не надо устанавливать. Минусы — медленно, меньше возможностей, в любой момент ваш любимый сайт может свернуться из-за наплыва пользователей/желания создателей.
- Через графический интерфейс и установщик. Мне кажется, такой способ должен быть привычнее большинству пользователей Windows, поэтому его и опишу. Минусы — не факт, что в графическом интерфейсе будут все нужные вам настройки. Плюсы — все наглядно и не надо ничего знать про всякие питоны, анаконды, пип-инсталлы, командные консоли.
2. Установка на своём компьютере
1. Еще раз убедитесь, что у вас Nvidia 10XX с хотя бы 4гб видеопамяти. Быстро проверить можно, зайдя в диспетчер задач (Ctrl+Shift+Esc), вкладку «производительность», раздел «Графический процессор» и посмотрев на строку «Выделенная память графического процессора».
2. Скачиваете программу-установщик от NMKD
nmkd.itch.io
NMKD Stable Diffusion GUI — AI Image Generator by N00MKRAD
Generate AI images on your own GPU for free
Нажимаете на красную кнопку «Download now» и решаете, поддержать ли вам разработчика деньгами или вы хотите скачать просто так. Никаких ограничений на вас не накладывается, если вы решите не платить. На следующей странице просто нажимаете «Download» и сохраняете архив там, где вам удобно. Весит 3 гигабайта.
3. Извлекаете содержимое архива куда вам удобно. Автор программы не рекомендует прятать ее очень глубоко из-за возможных ограничений на максимальную длину пути в файловой системе, но в данном случае это не так важно. Учтите, что программа + нейросети суммарно весят уже 11 гигабайт. У меня стоит на SSD, но не думаю, что это дает какую-либо ощутимую прибавку по скорости работы.
4. В распакованном архиве запускаете StableDiffusionGui.exe, соглашаетесь с возможными багами, и нажимаете на иконку установщика.
5. Последовательно нажимаете на «Download SD model», «Clone Repo», «Install Upscalers» и ждете, пока каждый из них скачается/установится. Прогресс можно наблюдать в левом нижнем углу приложения. Мне еще пришлось после этого делать Re-install, но вам может не пригодиться. Все поля должны быть отмечены галочками, если все прошло успешно.
Так установщик выглядит после всех процедур.
6. Последний шаг — настраиваем место сохранения результатов и потребление видеопамяти. Заходим в настройки, отмечаем галочкой Low Memory Mode (если у вас меньше 8 гб видеопамяти), выбираем место сохранения результатов и то, надо ли создавать отдельную папку под каждый новый запрос к нейросетке. Я рекомендую создавать под-папки, так проще потом делиться результатами с остальными. Если вдруг ваш запрос к нейросети очень длинный и Windows не создаст папку с таким названием — картинки сохранятся в базовой указанной вами папке.
У меня настройки выглядят так
Поздравляю, вы справились!
3. Генерируем изображения по тексту
Самый базовый вариант:
Вбиваете в поле Promt свой запрос, нажимаете Generate, ждете.
SD фанатет от Bomberman? Запрос неконкретный, результат — тоже
Какие настройки на что влияют (Подробнее — читайте в гайде):
- Сколько изображений нагенерировать. Больше изображений — дольше генерация, все просто.
- Steps — сколько шагов ИИ сделает в попытке выполнить ваш запрос. В теории, чем больше шагов, тем дольше обрабатывается запрос и качественнее результат, но на практике улучшение заметно не всегда. Для разных Sampler (о них ниже) оптимальное число шагов разное. По умолчанию рекомендуют 30-50. Если вас не устраивает какая-то часть изображения (например, глаза), лучше не увеличивать число шагов, а детализировать текстовый запрос к этой корявой части
- Creativeness (Guidance Scale) — насколько ИИ волен к интерпретации вашего запроса и должен ли он учитывать все его части. 2-6 — ИИ творит, что хочет, 7-11 — половину от вашего запроса возьмет, половину додумает, 12-15 — Постарается учесть большую часть вашего запроса, 16+ — Что написали, то и реализует. По умолчанию рекомендуется значение 8. Уверены в своем описании — 12.
- Seed — откуда ИИ будет стартовать свою отрисовку. Разные стартовые точки = разные итоговые результаты. Если вам не важна повторяемость результата — ставьте значение минус 1 . Если вы пытаетесь улучшить свой текстовый запрос — лучше зафиксируйте какое-то конкретное стартовое число и не меняйте его.
- Resolution — исходный разрешение получаемого изображения. Больше разрешение = больше видеопамяти нужно для генерации изображения. Нюансы — По умолчанию Stable Diffusion натренирован на изображениях 512*512, их он отрисовывает лучше всего. 256*256 — получается вырвиглазное нечто. Сделаете больше 512 — скорее всего он будет дублировать части изображения несколько раз в разных местах. Если вам нужно просто изображение большего разрешения, но с +- тем же числом деталей — лучше воспользоваться апскейлером (о них позднее). Не обязательно делать квадратные изображения, . Ходят слухи, что будет выпущена модель, обученная на 1024*1024 изображениях, но пока работаем с чем есть.
- Sampler. Я не знаю, как это работает «под капотом» (желающие объяснить — Welcome!), но с разными вариантами изображения генерируется немного по-разному. Наглядно это представлено на этом скрине:
Взято здесь .Первая и последняя строчка съехали относительно друг от друга на 1 позицию
Как это описывает сообщество:
k_lms: The Old Reliable.Вариант по-умолчанию. Каждый шаг отрабатывается сравнительно быстро, но для хорошего результата нужно 50-80 шагов.
k_ddim: The Speed Demon. Хорош уже на 8 шагах, что позволяет быстро перебирать множество вариантов.
k_euler_a: The Chameleon. Быстр, что-то интересное выдает уже на 8-16 шагах, но с каждым шагом изображение может кардинально поменяться.
k_dpm_2_a: The Starving Artist . Медленный на каждом шаге, нужно больше шагов для генерации приличного качества (50-80), но результат дает чуть более детализированный, по сравнению с тем же k_euler_a.
Для начала я обычно генерю с k_euler_a и 20 шагами. Если корявые глаза-руки, а в остальном норм — ставлю k_dpm_2_a и 75 шагов.
3.5 Особенности текстовых запросов
Если вы уже знакомы с Midjourney и тем, как хорошо генерировать запросы для него — переносите свои навыки на Stable Diffusion, только помните, что здесь нет команд вроде —wallpaper, —beta и нет опции разделять сущности через :: (можно через веса, об этом позже)
Если нет — я бы рекомендовал начать с Midjourney, по нему есть прекрасный гайд на ДТФ. Так как там вы в реальном времени смотрите, как другие люди создают и уточняют свои запросы и что при этом выдает нейросеть в каждой модификации.
Как пользоваться Midjourney или как не потратить впустую 25 круток (полный гайд)
Все вокруг говорят о волшебном ИИ, который способен создать шедевры из текстовых запросов пользователей интернета. Это первый пост в недавно созданном сообществе Midjourney, который является полной инструкцией к применению.
Если же сил возиться с еще одной нейросетью нет — Уже существуют сайты, на которых вы можете посмотреть, что выдаст SD при том или ином запросе (https://lexica.art/). Посмотрите на то, как люди формируют запросы по сходной тематике, вдохновитесь и используйте их как основу для своих собственных изображений. Удаляйте части запроса, добавляйте новые и смотрите к какому результату это приводит. Посмотрите на самые популярные работы в сообществе и как к ним был составлен текст.
Можете попробовать использовать генераторы описаний, в которых уже есть какие-то известные элементы описаний, на которые реагирует ИИ. Например, вот этот
Сейчас считается, что чем конкретнее и многословнее будет ваш запрос — тем лучше. Описывайте одно и то же разными словами. Хотите высокой детализации? Пишите «Masterpice, high quality, ultra-detailed, 4k» и что-нибудь еще. Или указывайте автора, рисующего в гипер-реалистичной манере через запрос «by %Фамилия-Имя автора%, из тех ,что есть в датасете LAION. Или даже несколько похожих авторов сразу.Или непохожих, для большей художественности. Что мешает смешать Моне и Ван Гога? Синьяка и Хокусая?
Учтите, что больше 75 слов за раз SD не воспринимает.
Важен также и порядок слов в запросе — чем ближе к началу, тем, по-умолчанию, больший вес этому слову придаст нейросеть. Так что ставьте на первые места те элементы, которые точно должны быть в изображении.
Хорошо сразу вряд-ли получится, не волнуйтесь. Для того, что бы получилось что-то, что уже хочется показать, обычно надо перебрать много разных модификаций одного и того же запроса, да еще и с разными настройками. Именно поэтому и не рекомендую начинать с k_lms и 50 шагами — когда генерируешь 100 разных запросов, имеет значение, сколько отрабатывает каждый из них.
Есть возможность вручную указывать веса для каждого элемента (насколько нейросеть должна учесть каждый). После целой фразы ставите «:xx», где xx — вес этого элемента при генерации.В сумме веса всех элементов должны давать 100. Пример запроса для генерации наполовину мини-дракона, наполовину — хорька под картинкой
a small cute blue dragon perched on a footstool, photography, Canon EOS, color, cinematic postprocessing:55 a cute brown ferret perched on a footstool, photography, Canon EOS, color, cinematic postprocessing:45 . От Smashcolor
4.Модификация готового изображения
Замечательная опция, о которой многие забывают — можно дать изображение, которое выступит основой для генерации.
Фотография моего коллеги в стиле Анри Руссо
У вас появится возможность настроить вес вашего исходного изображения и текстового описания, которое послужит основной для модификации. В данной программе чем ближе выставите слайдер Strength к 0, тем больше изображение будет похоже на текстовое описание. Чем ближе к 1 — тем больше на исходное изображение.
Я обычно выставляю около 0.4-0.6, получается сохранить детали и запроса и исходника. Когда ставлю больше 0.6 с фотографиями людей начинается творится хтонический ужас. Меньше — слишком далеко от оригинала.
5. А что дальше?
Начните уже что-то генерировать, получайте от этого удовольствие и дарите его другим. Следите за тем, какие новые возможности и удачные примеры появляются в сообществе на гитхабе/реддите и других площадках. Попробуйте освоить генерацию по образцу, когда вы используете набор изображений в качестве маленькой обучающей выборки, и потом генерируете изображения в этом новом «стиле».
Попробуйте использовать различные улучшатели изображений. В описываемом мной варианте есть два разных, один — для повышения разрешения, второй — для повышения качества лиц (RealESRGAN и GFPGAN)
Вызов апскейлера и корректировщика лиц скрывается под этой кнопкой.
Удачи! Делитесь не только интересными результатами, но и удачными комбинациями запросов и настроек!
Установка и использование Stable Diffusion для генерации изображений
Всё моё свободное время в последние четыре дня было потрачено на одну задачу — составление запросов для нейросети Stable Diffusion, нейросети для создания изображений по текстовому описанию. Все изображения для статьи (кроме скриншотов) были созданы лично в этой нейросети, совершенно не художником.
В этой инструкции подробно о том, как установить Stable Diffusion на ваш компьютер или ноутбук, о возможности попробовать нейросеть в работе без установки и некоторые дополнительные детали, которые могут оказаться полезными, если вы решите нырнуть в это также, как и я.
Установка Stable Diffusion
Нейросеть Stable Diffusion отличается от таких аналогов как DALL-E 2 или Midjourney открытым исходным кодом: то есть, при наличии соответствующего оборудования, вы можете совершенно бесплатно установить необходимое ПО на свой компьютер и использовать для создания изображений по текстовому запросу (в обсуждениях часто используют кальку с английского «промпт»).
Официальное ПО Stable Diffusion не имеет удобного графического интерфейса, за исключением доступного на официальном сайте https://beta.dreamstudio.ai/, с которого и рекомендую начать эксперименты и посмотреть, нужно ли вам это: после регистрации у вас будет 200 бесплатных генераций с параметрами по умолчанию (регистрироваться можно и больше раз с разными адресами электронной почты).
При установке официального софта на компьютере все действия придётся выполнять в командной строке. Кроме того, вы мало что сможете сгенерировать с видеокартой, имеющей 6 Гб памяти или менее.
Однако, благодаря открытому исходному коду, почти сразу после релиза Stable Diffusion появились альтернативные варианты ПО («форки»), оптимизирующие запуск на более слабом оборудовании (4 Гб VRAM, есть даже варианты, работающие на CPU, но очень медленно), предоставляющие удобный доступ к настройкам и упрощающие использование нейросети.
С одного из таких альтернативных вариантов, который я нашел наиболее удачным, и начнем установку. Если же вам требуется описание процесса установки официального варианта, его вы также сможете найти далее в статье.
Установка Stable Diffusion WebUI от Automatic
Сначала о том, что нам потребуется: достаточно мощный компьютер или ноутбук, видеокарта NVIDIA GeForce, не менее 4 Гб видеопамяти. Все устанавливаемые компоненты займут около 10 Гб на жестком диске или SSD. Если всё это в наличии, можно приступать:
- Установите Python 3.10.6 (разработчик указывает именно эту версию) с официального сайта https://www.python.org/downloads/windows/. При установке отметьте пункт «Добавить Python в переменную PATH».
- Установите Git с официального сайта https://git-scm.com/download/win. Если вам не ясны параметры при установке, их можно оставить в рекомендуемых по умолчанию значениях.
- Зайдите на страницу Automatic1111 на GitHub https://github.com/AUTOMATIC1111/stable-diffusion-webui, нажмите по стрелке справа от кнопки «Code» вверху справа и загрузите ZIP-архив со Stable Diffusion WebUI. Распакуйте в удобное расположение, но так, чтобы путь не содержал пробелов или кириллических символов (это может вызвать проблемы).
- Скачайте обученную модель Stable Diffusion последней версии с официального источника https://huggingface.co/CompVis/stable-diffusion-v-1-4-original (потребуется регистрация) или из этого хранилища.
- Переименуйте скачанный файл в model.ckpt и переместите его в папку, куда были распакованы файлы на 3-м шаге (в ту же папку, где находится файл webui.bat).
- Запустите файл webui-user.bat (не от имени администратора, простой запуск двойным кликом) и дождитесь, когда скрипт автоматически скачает и установит недостающие компоненты. Учитывайте: строка прогресса не отображается, поэтому при загрузке объемных компонентов (Torch и CUDA) может показаться, что процесс завис.
- По завершении установки вы увидите сообщение
Running on local URL: http://127.0.0.1:7860/
set COMMANDLINE_ARGS=--medvram
Установка официальной версии Stable Diffusion
При установке официальной версии Stable Diffusion все необходимые компоненты почти те же самые, но их потребуется устанавливать вручную. Требования те же самые, за исключением необходимости использования видеокарты с не менее чем 6 Гб VRAM.
- Скачайте и установите Git https://git-scm.com/download/win используйте рекомендуемые параметры (оставьте возможность использования Git в командной строке и сторонних программах).
- Установите Miniconda3 с официального сайта https://docs.conda.io/en/latest/miniconda.html, при установке выберите опцию «Установить для всех пользователей).
- Скачайте архив Stable Diffusion с официального источника https://github.com/CompVis/stable-diffusion (нажать по кнопке «Code», затем выбрать пункт «Download ZIP»).
- Скачайте модель Stable Diffusion последней версии с https://huggingface.co/CompVis/stable-diffusion-v-1-4-original (потребуется регистрация) или: из этого хранилища (без регистрации), переименуйте файл в model.ckpt
- Запустите консоль Miniconda3 (Anaconda Prompt), для этого можно использовать поиск в панели задач Windows 11 и Windows
- В открывшейся консоли используйте команды для создания папки (в нашем варианте — на диске C) для файлов Stable Diffusion
cd C:/ mkdir stable-diffusion cd stable-diffusion
cd C:\stable-diffusion\stable-diffusion-main conda env create -f environment.yaml conda activate ldm mkdir models\ldm\stable-diffusion-v1
conda activate ldm
python scripts/txt2img.py --prompt "concept robot, colorful, cinematic" --plms --n_iter 5 --n_samples 1
Команда создаст набор из 5 изображений с разрешением 512×512 по запросу «concept robot, colorful, cinematic», которые будут помещены в папку
C:\stable-diffusion\stable-diffusion-main\outputs\txt2img-samples\samples
Чтобы увидеть информацию по доступным параметрам командной строки используйте команду
python scripts/txt2img.py --help
Использование Stable Diffusion WebUI
После запуска webui-user.bat и перехода в браузере на адрес 127.0.0.1:7860 перед вами будет веб-интерфейс, доступный локально на вашем компьютере (для работы Интернет не требуется), первая вкладка которого — txt2img, где и происходит всё самое интересное. Экспериментировать можно начать сразу же: просто введите текст на английском в поле сверху и нажмите кнопку «Generate», чтобы получить готовую картинку с параметрами по умолчанию (на скриншоте они уже изменены).
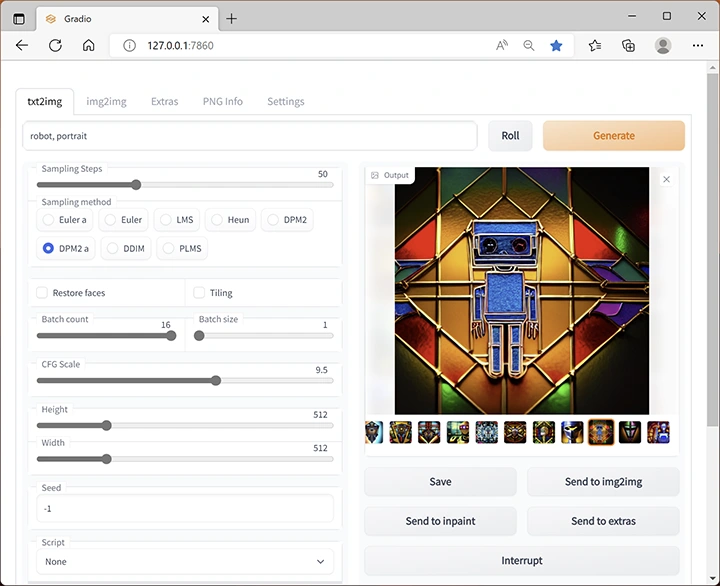
Если поднести указатель мыши к названию доступных параметров, большинство из них имеют описания на английском. Среди основных:
- Sampling Method — алгоритм создания изображения. Влияет на результат, скорость, требуемую видеопамять.
- Sampling Steps — количество шагов, в течение которых нейросеть «приводит» результат к желаемому. Влияет на время генерации. Больше — не всегда лучше: нужный результат может получиться за 30-50 шагов, а дальнейшая работа может не добавить деталей, а исказить результат (но бывает и иначе). Если то, что получилось, вам понравилось, можно использовать тот же Seed для генерации изображения по этому же запросу, но с другим количеством шагов и оценить результат.
- Batch count — количество наборов создаваемых изображений.
- Batch size — количество изображений в наборе (влияет на требуемую память).
- CGF Scale — «свобода» обработчика изображения, влияет на то, насколько точно результат будет соответствовать описанию. При более низких значениях получаем большее разнообразие.
- Height и Width — ширина и высота изображения, очень сильно влияет на требования к памяти.
- Seed — «зерно». По умолчанию равно -1, при этом значении оно будет задано случайно при каждом очередном нажатии кнопки «Generate». Если с определенным Seed вы получили интересный результат, можете скопировать его в это поле, чтобы продолжить эксперименты над понравившимся изображением, изменяя параметры.
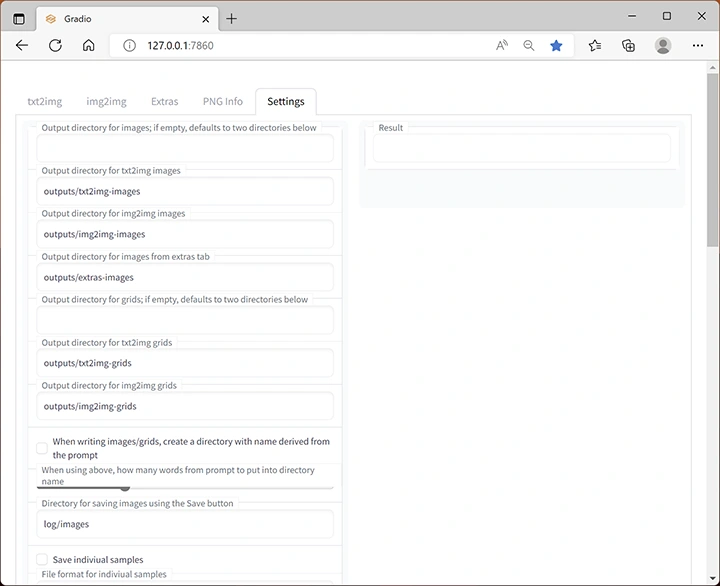
По умолчанию изображения сохраняются во вложенных папках в папке outputs в расположении, куда вы установили Stable Diffusion WebUI, но при желании автоматическое сохранение можно отключить на вкладке «Settings», здесь же можно настроить и другие параметры.
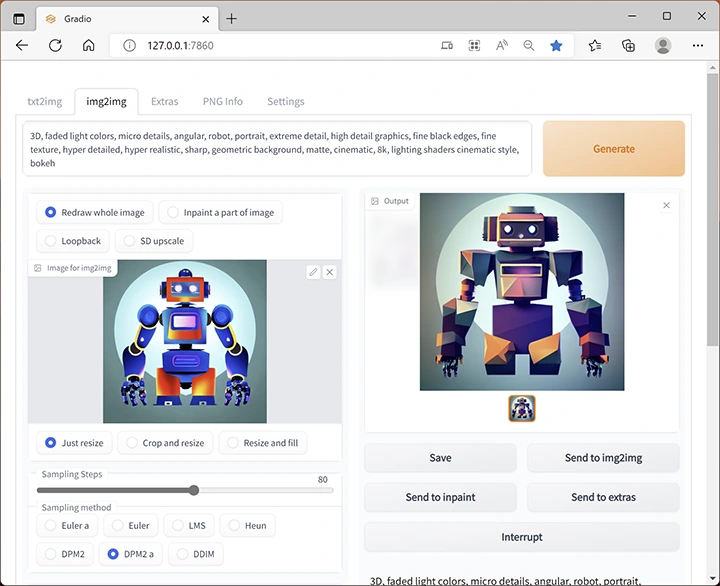
Вкладка img2img позволяет модифицировать имеющееся изображение в соответствии с текстовым описанием.
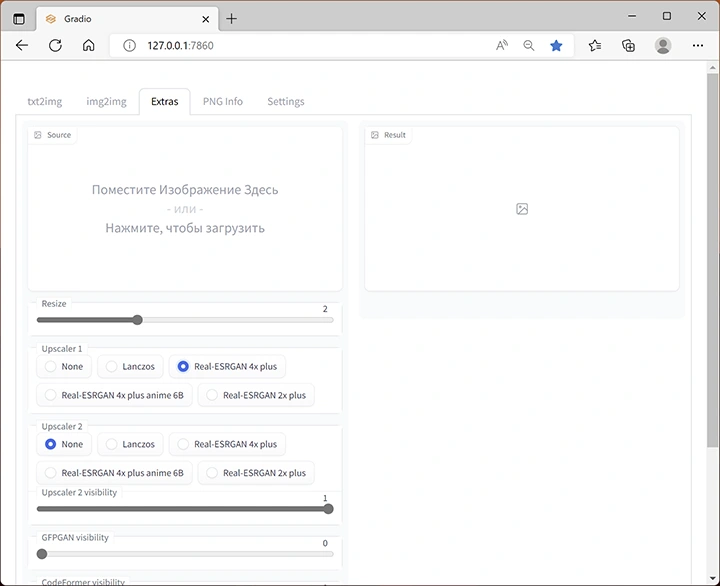
На вкладке Extras собраны дополнительные инструменты. Основное — увеличение разрешения изображения с использованием нейросети.
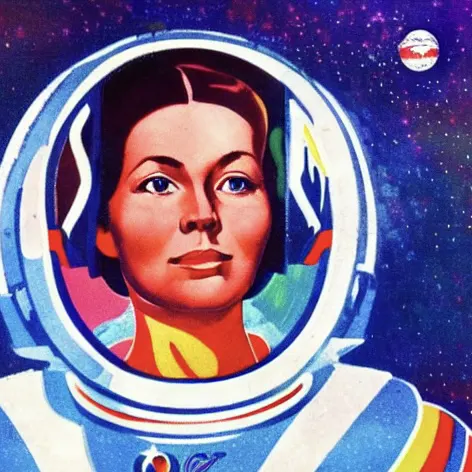
Значения параметров в большинстве своем вам придётся подбирать самостоятельно, отслеживая результат. Но даже при одних и тех же значениях он может сильно отличаться и прежде всего зависит от заданного запроса, прописанных в нем требований к изображению и стилей. Это может быть простой рисунок в стиле плаката:
А может быть и почти фотография:
Легко создать таких роботов:
И посложнее — таких:
Не забывайте проявлять фантазию, нарисовать можно многое, главное уметь это описать:
Вспоминайте названия кинематографических эффектов, свойств материалов и описания форм:
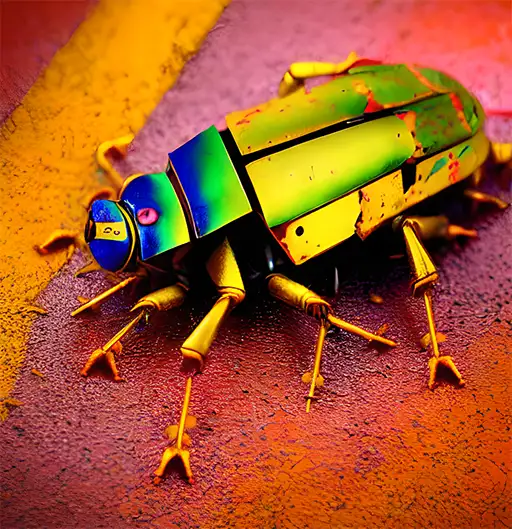
Чтобы получить лучшие результаты, рекомендую изучить чужие работы и используемые запросы: на тему создания изображений в Stable Diffusion есть множество тематических каналов в мессенджерах, социальных сетях и тематических сайтах. Но и собственные идеи часто могут дать интересный и красивый эффект, время для неожиданных находок в запросах ещё не вышло.
А вдруг и это будет интересно:
- Лучшие бесплатные программы для Windows
- Ноутбук тормозит на зарядке или без неё — причины и варианты решения
- 403 Forbidden — что это за ошибка и как исправить?
- Непредвиденная ошибка компонента службы теневого копирования томов — как исправить?
- Ошибка 0x00000005 в Microsoft Store — как исправить?
- Как добавить папку в панель навигации Проводника Windows
- Windows 11
- Windows 10
- Android
- Загрузочная флешка
- Лечение вирусов
- Восстановление данных
- Установка с флешки
- Настройка роутера
- Всё про Windows
- В контакте
- Одноклассники
-
Alex 16.09.2022 в 09:24
- Dmitry 16.09.2022 в 18:04
- Alex 16.09.2022 в 20:24